


산업기술

산업 제조
이제 누구나 머신러닝과 그것이 모든 것을 바꿀 것이라는 이야기를 들어봤을 것입니다. 하지만 어떻게 시작해야 할지 아는 사람은 드뭅니다. 이 블로그의 단계를 따라하거나 읽어보는 것만으로도 PLCnext 컨트롤러로 머신러닝을 시작하는 방법을 이해하는 데 도움이 되길 바랍니다. 여기서는 첫 ML 모델 훈련, ONNX 표준으로 변환, PLCnext 컨트롤러에서 모델 추론까지 다룹니다. 유명한 아이리스 데이터셋을 사용해 모델을 구축하겠습니다.
머신러닝의 핵심은 통계와 알고리즘을 사용해 데이터셋에서 패턴을 찾는 것입니다. 세 가지 주요 유형으로 나뉩니다: 지도 학습, 비지도 학습, 강화 학습. 지도 학습이 오늘날 가장 널리 사용되며 이 블로그에서도 지도 학습을 사용합니다. 지도 학습에서는 데이터를 레이블링하고 기계에게 정확히 어떤 패턴을 찾아야 할지 알려줍니다.
비지도 학습에서는 데이터를 레이블링하지 않고 기계가 스스로 패턴을 찾게 합니다. 적용 분야가 덜 명확해 덜 대중적입니다.
강화 학습에서는 알고리즘이 시행착오를 통해 명시된 목표를 달성하게 학습합니다. 좋은 행동에는 보상, 나쁜 행동에는 페널티를 줍니다. 구글의 알파고(AlphaGo)가 유명한 예입니다.
위키피디아에 따르면 아이리스 꽃 데이터셋은 1936년 로날드 피셔가 소개한 다변량 데이터셋으로, 세 가지 아이리스 품종(Setosa, Versicolor, Virginica) 각각 50개 샘플의 꽃받침 길이/너비, 꽃잎 길이/너비를 포함합니다.
데이터셋에는 5개 필드가 있습니다: 꽃받침 길이, 꽃받침 너비, 꽃잎 길이, 꽃잎 너비, 아이리스 품종. 우리의 목표는 꽃받침/꽃잎 길이/너비를 알 때 아이리스 품종을 분류하는 것입니다. 이는 분류(classification) 유형의 머신러닝입니다.
머신러닝으로 데이터셋의 값을 예측하는 회귀(regression)도 있으며, 분류와 다른 알고리즘을 사용합니다.
이번에는 의사결정 트리 분류기(Decision Tree Classifier)를 사용합니다. 작업에 완벽해서가 아니라, 복잡한 수학 없이 직관적으로 이해하기 쉽기 때문입니다. 아래는 아이리스 데이터셋용 의사결정 트리 예시입니다.
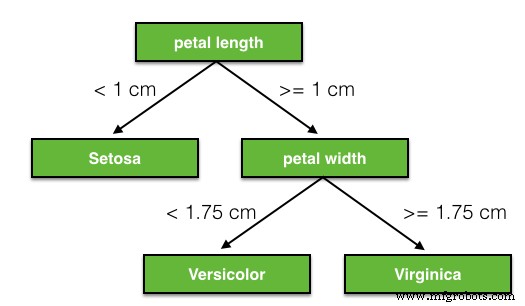
머신러닝 모델은 다양한 형식으로 제공되고, 다양한 하드웨어와 가속 방식에서 실행돼야 합니다. ONNX는 이 문제를 완화하려 합니다. 오픈오피스, Azure 등 전 세계 수많은 애플리케이션에서 사용되며, 이 글을 읽는 기기에서도 거의 확실하게 사용되고 있습니다.
ONNX 모델을 실행하려면 ONNX Runtime이 필요한데, 특히 ARM 프로세서에서 어려움이 있습니다. 하지만 제공되는 Docker 이미지를 사용하면 문제없이 실행할 수 있습니다.
이 GitHub 저장소 내용을 다운로드하고 필요한 패키지가 모두 설치됐는지 확인하세요. 먼저 훈련 스크립트를 실행해 모델을 아이리스 데이터셋에 피팅합니다. 훈련 스크립트의 코드 조각입니다. 이 스크립트는 훈련된 모델을 포함한 .onnx 파일을 생성합니다.
# 데이터셋을 훈련용과 테스트용으로 분할
iris = load_iris()
X, y = iris.data, iris.target
X_train, X_test, y_train, Y_test = train_test_split(X, y)

# 모델 정의 및 훈련 데이터로 피팅, 모델 정보 출력
clr = DecisionTreeClassifier()
clr.fit(X_train, y_train)
print(clr)

# 모델을 sklearn 형식에서 ONNX로 변환
initial_type = [('float_input', FloatTensorType([None, 4]))]
onx = convert_sklearn(clr, initial_types=initial_type)
with open("decision_tree_iris.onnx", "wb") as f:
    f.write(onx.SerializeToString())
개발 머신에서 모델을 실행해 확인합니다. 추론 스크립트를 실행하면 아이리스 꽃 품종에 해당하는 두 개의 정수가 출력돼야 합니다.
import numpy as np
import onnxruntime as rt

X_test = np.array([[5.8,4.0,1.2,0.2],[7.7,3.8,6.7,2.2]])

sess = rt.InferenceSession("decision_tree_iris.onnx")
input_name = sess.get_inputs()[0].name
label_name = sess.get_outputs()[0].name
pred_onx = sess.run(
    [label_name], {input_name: X_test.astype(np.float32)})[0]
print(pred_onx)

# 출력: [0 2]
좋아하는 SFTP 클라이언트로 .onnx 파일과 inference.py를 PLCnext 컨트롤러의 /opt/plcnext/onnx에 업로드합니다. 루트 권한으로 다음 명령 실행:
balena-engine run -it --name onnx -v /opt/plcnext/onnx/:/app pxcbe/onnx-runtime-arm32v7
Python 추론 스크립트 실행:
cd /app
python3 /app/inference.py
모든 것이 잘 됐다면 Ubuntu VM에서와 동일한 출력을 얻을 수 있습니다. 축하합니다! 이제 변화를 만들어보세요.
사실 아직 끝나지 않았습니다. 아이리스 꽃 분류는 재미있지만 논리 컨트롤러에서 여러 응용을 상상하긴 어렵습니다. 자체 모델을 만들고 해당 모델용 API를 생성해 추론에 사용해야 합니다. OPC UA로 모델에 데이터를 전달하거나 커스텀 REST 엔드포인트를 구축할 수 있습니다. 어쨌든 여기 제공된 코드보다 더 많은 코드를 작성해야 합니다.
이미지 빌드에 며칠과 밤을 새운 경험을 고려해, 제공된 이미지 위에 빌드하는 것을 권장합니다. 참고 자료에서 Python 컨테이너 앱 빌드에 대한 좋은 자료를 찾을 수 있습니다.
산업기술
작성: Adam Poole, 제품 디자인 리드 기술은 우리 삶을 더 쉽게 만들 때만 가치가 있습니다. 하지만 이 단순한 진리가 최신 기술 마법 홍보 속에서 잊히곤 합니다. 업무 환경에서 사람들이 가장 원하지 않는 건 관리해야 할 추가 시스템이라는 두통을 안겨주는 솔루션입니다. 스마트 팩토리와 인더스트리 4.0을 둘러싼 현재 혁신과 열광의 물결 속에서, 사람들의 업무 삶을 더 복잡하게 만드는 게 아니라 더 강한 비즈니스를 구축하도록 지원하는 솔루션을 찾는 게 그 어느 때보다 중요합니다. 자유롭게 흐르는 데이터가 이 스마트 환경의 주
머신러닝(Machine Learning)은 인공지능(AI) 한 갈래로, 기계가 명시적 프로그래밍 없이 실제 데이터로부터 학습하는 기술입니다. 산업 현장에서 이 알고리즘이 주는 이점과 활용법을 살펴봅니다. 머신러닝 기초 AI 분파로, 알고리즘이 실데이터 학습 → 모델 생성 → 신규 데이터 클래스/유형 예측. 두 주요 패러다임: 지도 학습(Supervised Learning): 정답 레이블 붙은 데이터셋 필요 비지도 학습(Unsupervised Learning): 레이블 없이 데이터 특성 기반 자율 군집화·분류 핵심 역량: 패