XML(eXtensible Markup Language)은 구조화된 데이터를 효율적으로 저장하고 전송하기 위해 만들어졌습니다. 시스템과 애플리케이션 간 정보 교환에 널리 사용됩니다.
파이썬은 XML 문서 파싱과 조작을 위한 강력한 라이브러리를 제공합니다. 다만 XML 파일을 파싱하려면 전체 문서가 먼저 메모리에 로드되어야 합니다. 이 튜토리얼에서는 파이썬의 xml.dom.minidom과 xml.etree.ElementTree 모듈을 사용하여 XML 파일을 읽고, 검사하고, 수정하는 방법을 보여줍니다.
이 가이드를 마치면 다음을 할 수 있습니다:
minidom으로 XML 파싱
새 XML 노드 생성
ElementTree로 XML 파싱
minidom으로 XML 파싱
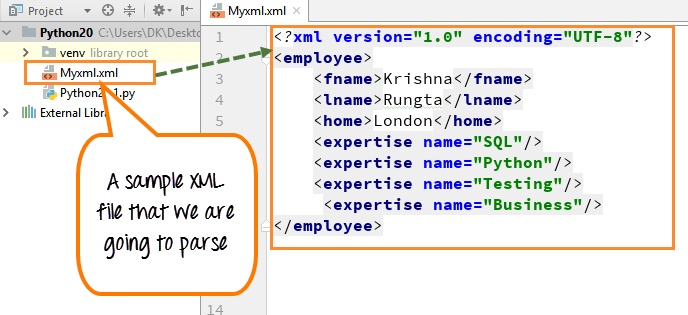
직원 데이터를 포함한 샘플 XML 파일로 시작합니다. 파일 구조는 다음과 같습니다:
1단계) 파일에는 직원의 이름, 성, 집, 전문 분야(SQL, Python, Testing, Business 등)가 나열됩니다.
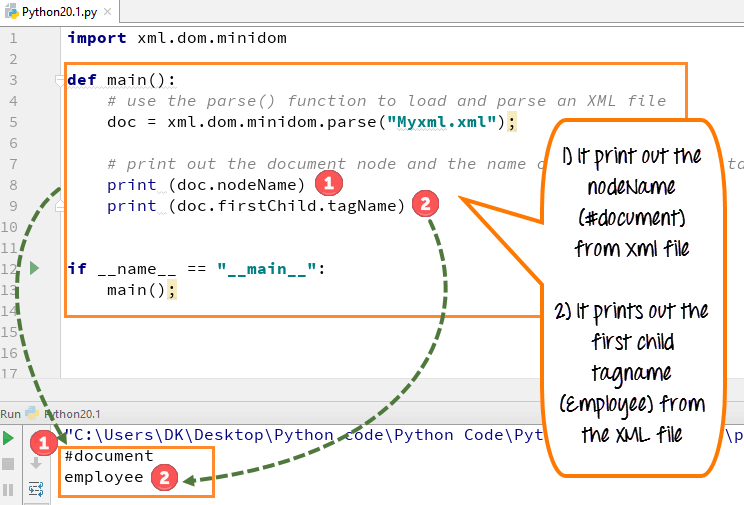
2단계) 문서 로드 후 루트 요소의 nodeName과 첫 번째 자식의 tagName을 출력합니다. 이는 DOM 객체의 표준 속성입니다.
xml.dom.minidom 임포트 후 XML 파일(myxml.xml) 로드
parse()로 파싱하여 문서 객체 획득
문서의 nodeName과 첫 자식의 tagName 조회 및 출력
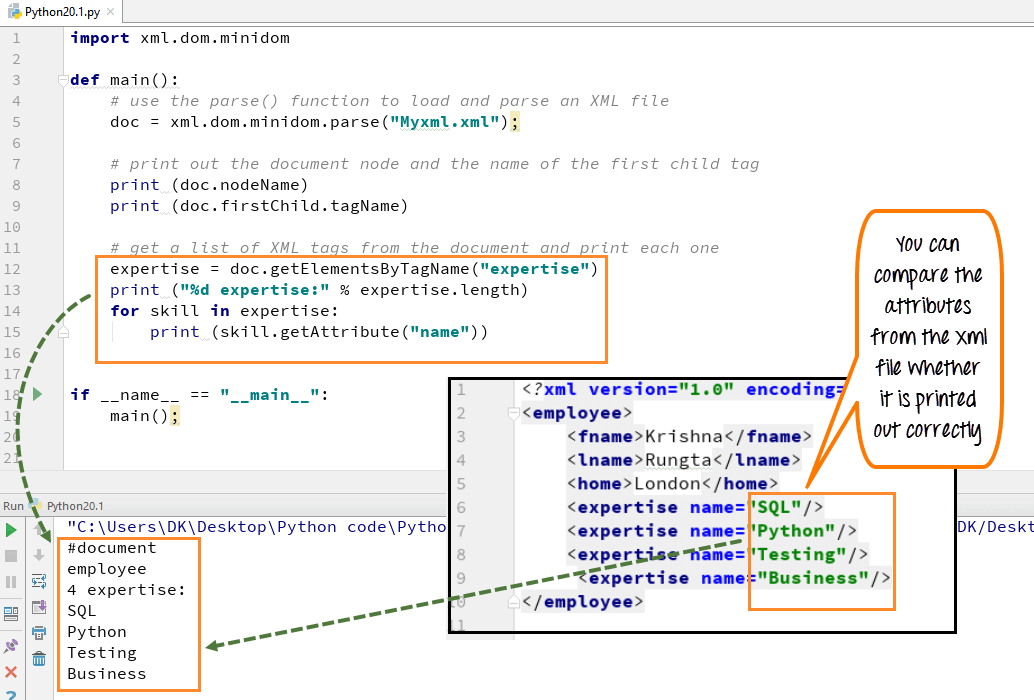
getElementsByTagName()으로 모든 expertise 요소 나열 및 각 기술 출력
참고:nodeName과 tagName 값은 XML DOM 명명 규칙을 따르며, XML 입문자에게는 생소할 수 있습니다.
3단계) 문서에서 모든 기술 목록을 추출할 수 있습니다. 다음 코드는 기술 이름을 집합으로 모으는 방법을 보여줍니다.
getElementsByTagName("skill")로 모든 skill 요소 조회
반환된 리스트를 순회하며 각 skill의 name 속성 출력
새 XML 노드 생성
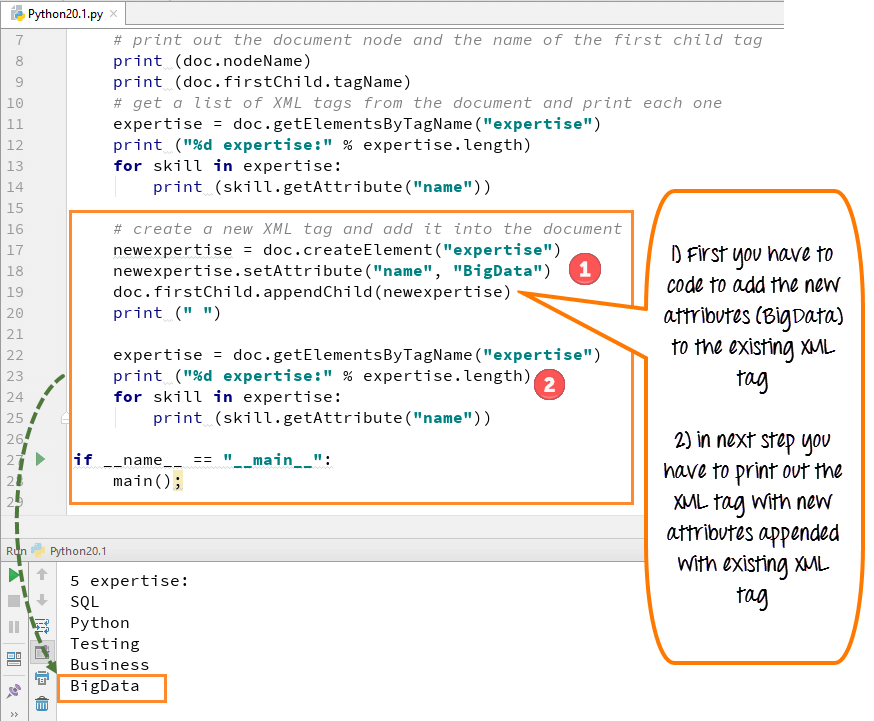
minidom을 사용하면 기존 XML 구조에 새 데이터를 추가하기 쉽습니다. 예제에서는 "BigData" 레이블의 새 expertise 노드를 추가합니다.
createElement("expertise")로 새 요소 생성 후 name 속성 설정
문서의 루트 자식에 새 요소 추가
삽입 후 expertise 목록에 새로운 "BigData" 기술 포함
XML 파서 예제
파이썬 2 예제
import xml.dom.minidom
def main():
    # XML 파일 로드 및 파싱
    doc = xml.dom.minidom.parse("Myxml.xml")
    # 루트 정보 출력
    print doc.nodeName
    print doc.firstChild.tagName
    # 기존 expertise 항목 나열
    expertise = doc.getElementsByTagName("expertise")
    print "%d expertise:" % expertise.length
    for skill in expertise:
        print skill.getAttribute("name")
    # 새 expertise 항목 추가
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print " "
    # 추가 확인
    expertise = doc.getElementsByTagName("expertise")
    print "%d expertise:" % expertise.length
    for skill in expertise:
        print skill.getAttribute("name")

if __name__ == "__main__":
    main()
파이썬 3 예제
import xml.dom.minidom
def main():
    # XML 파일 로드 및 파싱
    doc = xml.dom.minidom.parse("Myxml.xml")
    # 루트 정보 출력
    print(doc.nodeName)
    print(doc.firstChild.tagName)
    # 기존 expertise 항목 나열
    expertise = doc.getElementsByTagName("expertise")
    print("%d expertise:" % expertise.length)
    for skill in expertise:
        print(skill.getAttribute("name"))
    # 새 expertise 항목 추가
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print(" ")
    # 추가 확인
    expertise = doc.getElementsByTagName("expertise")
    print("%d expertise:" % expertise.length)
    for skill in expertise:
        print(skill.getAttribute("name"))

if __name__ == "__main__":
    main()
ElementTree로 XML 파싱
ElementTree는 XML 조작을 단순하고 파이썬답게 만드는 경량 API입니다. 전체 DOM의 오버헤드 없이 큰 XML 파일을 읽기에 이상적입니다.
tree = ET.parse('items.xml')
root = tree.getroot()
모든 기술 이름을 표시하는 전체 코드:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()
print('Expertise Data:')
for elem in root:
    for subelem in elem:
        print(subelem.text)
출력:
Expertise Data:
SQL
Python
요약
파이썬의 xml.dom.minidom과 xml.etree.ElementTree 모듈은 개발자가 XML 문서를 효율적으로 로드, 분석, 수정할 수 있게 합니다. minidom은 복잡한 조작에 적합한 전체 DOM 표현을 제공하는 반면, ElementTree는 간단한 파싱과 추출을 위한 경량 대안을 제공합니다.
parse()로 XML 로드(예: doc = xml.dom.minidom.parse(file))