은닉층 크기 최적화로 신경망 정확도 높이기
이 글에서는 분류 실험을 수행하고 은닉층 차원이 신경망 성능에 미치는 영향을 분석합니다.
퍼셉트론의 은닉층 조정이 어떻게 정확도 향상, 학습 시간 단축, 허용 가능한 지연시간 유지에 기여하는지 Python 구현과 실제 데이터셋으로 시연합니다.
시작하기 전에 우리 신경망 시리즈의 이전 글을 복습해 탄탄한 기초를 다지세요:
- 신경망으로 분류 수행: 퍼셉트론이란?
- 단순 퍼셉트론 예제로 데이터 분류하기
- 기본 퍼셉트론 신경망 학습시키기
- 단순 신경망 학습 이해
- 신경망 학습 이론 입문
- 신경망의 학습률 이해
- 다층 퍼셉트론으로 고급 머신러닝
- 시그모이드 활성화 함수: 다층 퍼셉트론에서의 활성화
- 다층 퍼셉트론 신경망 학습시키기
- 다층 퍼셉트론의 학습 공식과 역전파 이해
- Python 구현을 위한 신경망 아키텍처
- Python으로 다층 퍼셉트론 신경망 만들기
- 신경망을 이용한 신호 처리: 신경망 설계에서의 검증
- 신경망용 학습 데이터셋: Python 신경망 학습 및 검증
- 신경망에 필요한 은닉층과 은닉 노드 수?
- 은닉층 신경망 정확도 높이기
은닉층 노드 수는 분류 정확도와 학습 속도에 직접 영향을 미칩니다. 실험을 통해 속도, 지연시간, 정확도 균형을 맞추는 은닉층 크기 선택에 데이터 기반 직관을 제공합니다.
Python 벤치마킹
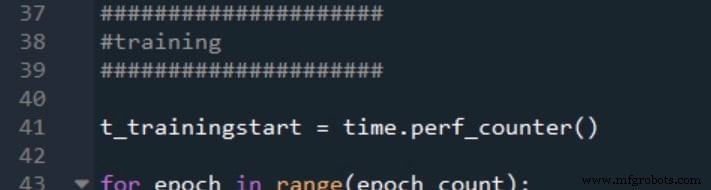
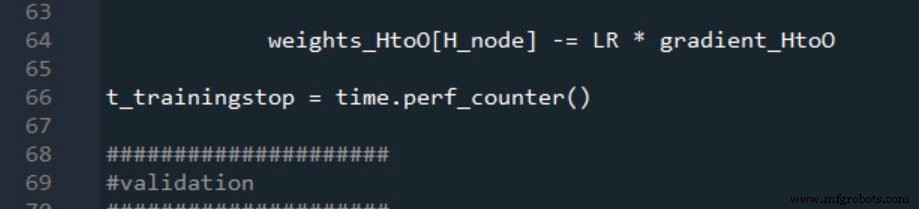
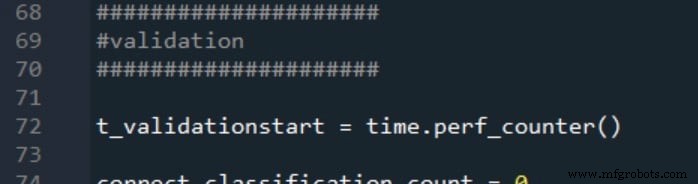
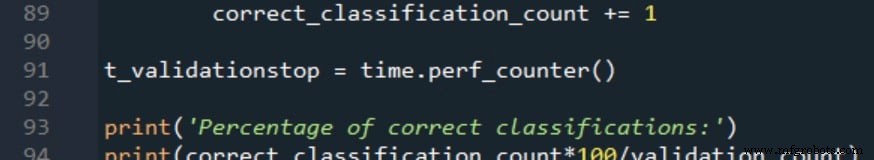
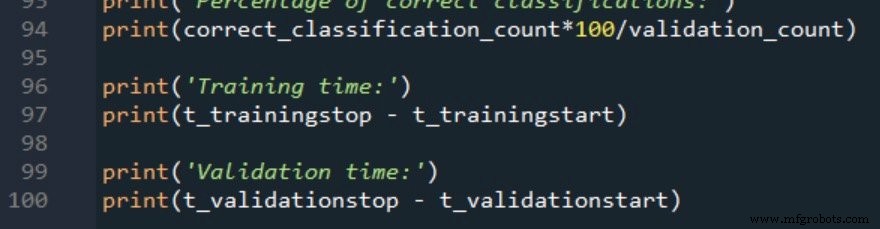
12편의 기존 Python 코드를 보강해 time.perf_counter()로 학습·검증 소요 시간 기록. 타이밍 계측 코드는 아래와 같습니다:
검증 타이밍도 같은 패턴:
결과는 다음과 같이 보고:
학습 데이터와 측정 절차
–20~+20 범위의 4개 숫자 입력을 사용하는 이진 분류 작업 테스트. 네트워크 아키텍처: 4 입력 노드, 단일 은닉층, 1 출력 노드. 입력값은 아래 엑셀 공식으로 생성:
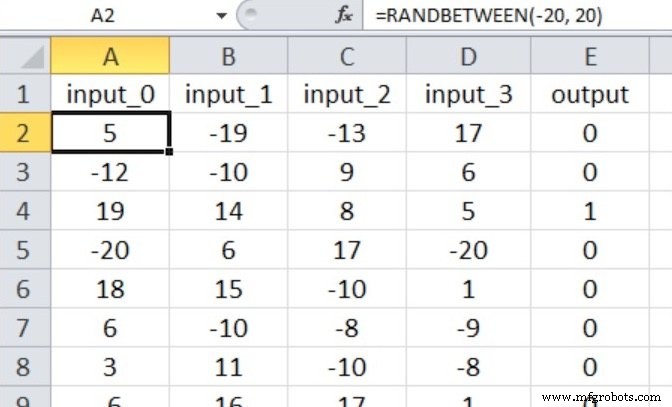
데이터셋 크기: 40,000 학습 샘플, 5,000 검증 샘플. 학습률 0.1, 실행당 1 에포크. 각 은닉층 차수 5회 테스트; 보고된 정확도와 시간은 산술 평균.
실험 1: 저복잡도 문제
타겟은 처음 세 입력이 0 초과일 때만 참, 네 번째 입력은 무관:
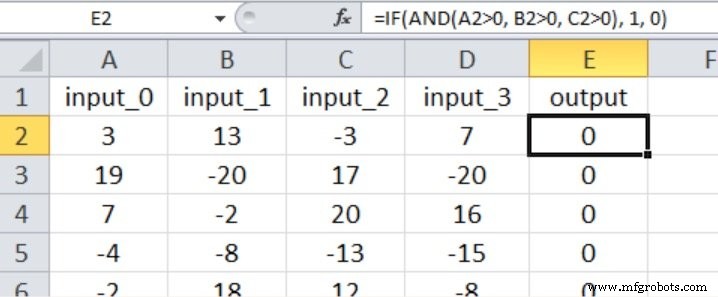
입력 크기의 2/3 지침 따라 H_dim = 2로 시작. 결과 요약:
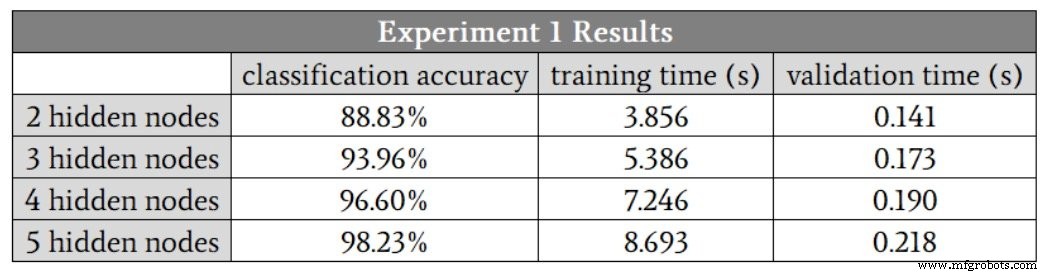
정확도는 5개 은닉 노드까지 향상되지만 4→5 노드 한계 이득은 미미(4노드 한 실행이 88.6% 아웃라이어). 아웃라이어 제거 시 4노드가 5노드보다 약간 우수. 학습 시간은 2→4노드 1.9배 증가, 검증 시간은 1.3배만 증가해 학습이 더 계산 집약적임 확인.
실험 2: 중복잡도 문제
네 입력이 모두 출력에 영향, 더 미묘한 비교:
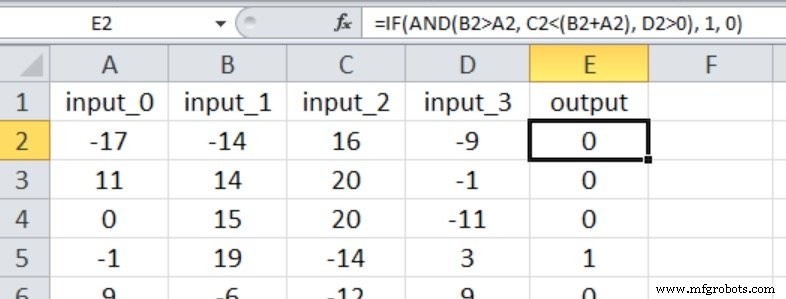
3개 은닉 노드로 시작. 결과:
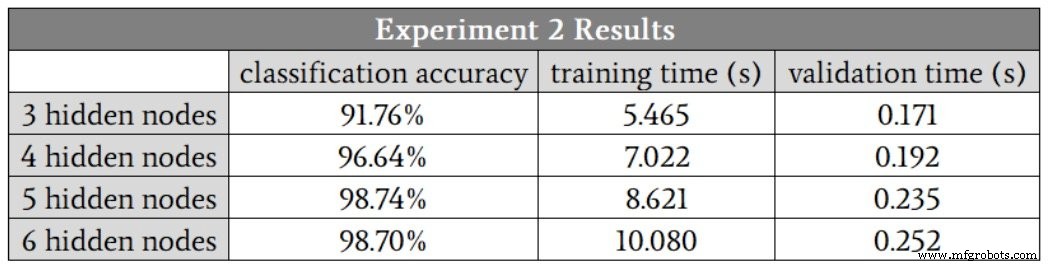
여기선 5개 은닉 노드가 정확도와 속도 균형에 최적. 실험 1과 달리 5·6노드 실행에 저정확도 아웃라이어 없어 더 큰 은닉층이 학습 분산에 대한 강건성 부여 시사.
실험 3: 고복잡도 문제
비선형성 도입: 한 입력 제곱, 다른 하나 제곱근:
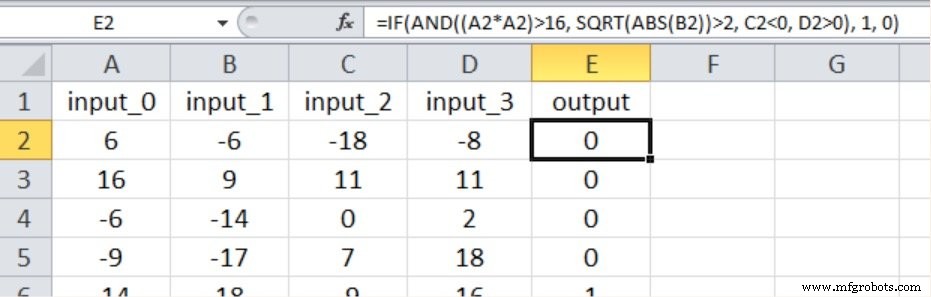
결과:
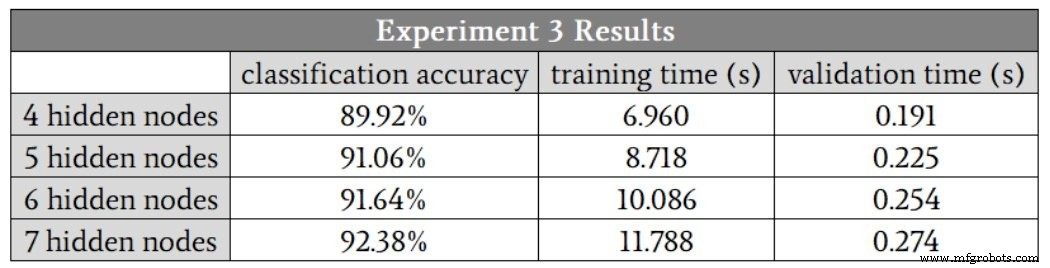
저복잡도 작업 대비 정확도 하락, 7개 은닉 노드에서도. 바이어스 항 추가나 학습률 어닐링으로 성능 개선 가능하지만 검증 전까지 7노드 은닉층 권장.
결론
실험은 명확한 트레이드오프 보여줍니다: 은닉층 차원 증가는 일반적으로 정확도와 안정성 향상하지만 학습 시간 증가 비용. 여기 데이터 기반 통찰로 퍼셉트론 기반 분류기 설계 시 선택 참고하세요.



