스마트 스피커와 음성 제어 디바이스가 빠르게 확산되면서 Amazon Alexa, Google Assistant 같은 비서들이 업데이트마다 우리의 음성 명령을 해독하는 능력이 향상되고 있습니다.
이 인터페이스의 가장 큰 매력은 학습 곡선 없이 자연스러운 대화만으로 작동하는 손쉬운 특성입니다. 그 매끄러운 경험 뒤에는 원시 오디오를 명확하고 실행 가능한 요청으로 변환하는 정교한 신호 처리 단계 체인이 있습니다.
이 기사에서는 음성 제어 솔루션을 구동하는 아키텍처를 조사하여 이를 생생하게 만드는 하드웨어와 소프트웨어의 숨은 계층을 드러냅니다.
신호 흐름과 아키텍처
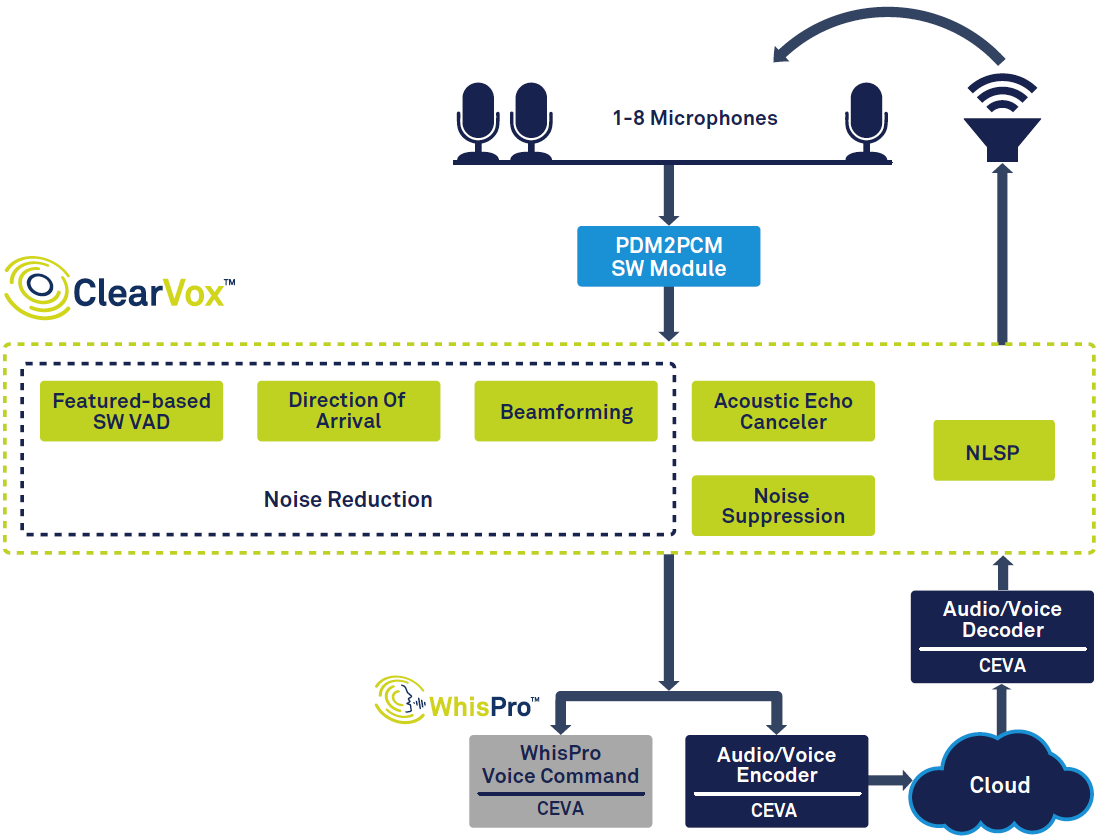
구체적인 사항은 제품마다 다르지만 기본 흐름은 일관됩니다. Amazon Echo 같은 스마트 스피커를 예로 들어 주요 서브시스템을 그림 1에 나타냈습니다.
클릭하면 확대 이미지 그림 1: CEVA의 ClearVox와 WhisPro 기반 음성 비서 신호 체인. (출처: CEVA)
체인은 음성 활동 감지(VAD)로 시작하여 음성 세그먼트를 분리합니다. 캡처된 오디오는 디지털화되어 사용자의 도착 방향에 초점을 맞춰 선명도를 높이는 일련의 프론트엔드 알고리즘을 거칩니다. 처리된 신호는 백엔드 음성 처리로 전달되며, 이는 디바이스(에지)에서 부분적으로, 클라우드에서 부분적으로 실행될 수 있습니다. 마지막으로 응답(텍스트 또는 음성)이 합성, 디코딩되어 스피커의 디지털-아날로그 경로를 통해 렌더링됩니다.
유스 케이스에 따라 변형이 생깁니다. 예를 들어 차량 내 음성 인터페이스는 도로 소음을 해결해야 하며, 새로운 웨어러블은 초저전력과 최소 비용을 요구합니다.
프론트엔드 신호 처리
VAD와 디지털화 후 디바이스는 원치 않는 소리를 억제해야 합니다. 어쿠스틱 에코 캔슬링(AEC)은 디바이스 자체 재생으로 인한 반사를 제거하여 음악 재생 중에도 원활한 '바지인(barge-in)'을 가능하게 합니다. 노이즈 억제는 잔여 배경 히스를 정리합니다.
음성 제어 디바이스는 근거리(헤드셋, 이어버드)와 원거리(스마트 스피커, TV) 두 범주로 나뉩니다. 근거리 유닛은 일반적으로 1-2개 마이크를 사용하는 반면, 원거리 유닛은 3-8개 마이크를 배치합니다. 후자는 더 가혹한 음향 환경에 직면합니다: 목소리는 거리에 따라 약해지고, 배경 소음은 일정하며, 잔향이 신호 추출을 복잡하게 만듭니다.
원거리 유닛은 마이크 간 시간 차이에서 소스 방향을 계산하는 빔포밍을 사용합니다. 이를 통해 시스템은 사용자에 초점을 맞추고 반사를 무시하며 움직임을 추적하고 여러 목소리가 있을 때 단일 화자를 분리할 수 있습니다.
트리거 워드 감지(예: '알렉사')는 중요한 기능입니다. 지속적 청취는 프라이버시 우려를 제기하므로 많은 시스템이 웨이크 워드 인식을 로컬에서 수행하고 전체 명령이 감지된 후에만 오디오를 클라우드로 전송합니다.
정제된 음성 샘플은 클라우드 백엔드에서 더 깊은 분석을 위해 전송되기 전에 인코딩됩니다.
특화 솔루션
프론트엔드 처리는 빠르고 정확하며 전력 효율적이어야 합니다. 특히 배터리 구동 웨어러블에서는 더욱 그렇습니다. 범용 DSP나 CPU는 비용, 크기, 에너지 소비 측면에서 이러한 요구를 충족하기 어렵습니다. 해결책은 오디오 작업용으로 설계된 애플리케이션 특화 DSP입니다.
CEVA의 ClearVox는 다양한 음향 시나리오에서 멀티마이크 빔포밍, 도착 방향 추정, 노이즈 억제, AEC를 처리하는 소프트웨어 제품군입니다. CEVA 사운드 DSP에 최적화된 ClearVox는 고품질 음성 캡처를 위한 저비용, 저전력 경로를 제공합니다.
트리거 워드 감지는 CEVA의 WhisPro가 처리합니다. CEVA DSP 전용의 신경망 기반 인식기인 WhisPro는 웨이크 워드가 감지될 때까지 메인 프로세서를 재워 전체 시스템 전력을 크게 줄이면서 95% 이상의 인식률을 유지합니다. 다중 트리거 구문과 커스텀 단어를 지원하며, 이는 소비자 만족도에 중요한 요소입니다.
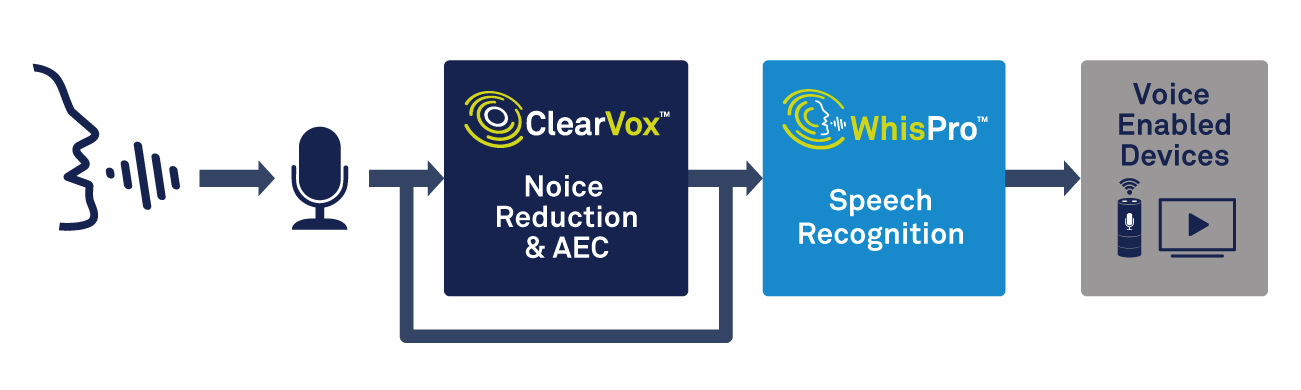
클릭하면 확대 이미지 그림 2: 음성 처리와 음성 인식을 이용한 음성 활성화. (출처: CEVA)
음성 인식: 로컬 또는 클라우드
오디오가 정제되고 디지털화되면 다음 단계는 자동 음성 인식(ASR)입니다. 스펙트럼은 단순한 키워드 스포팅부터 본격적인 자연어 처리(NLP)까지 다양합니다. 키워드 감지는 좁은 범위 디바이스(예: 스마트 온도조절기)에 이상적이며, 오프라인 즉각적 응답을 가능하게 합니다.
반면 많은 애플리케이션은 문맥 이해가 필요합니다. '도심 근처 가성비 좋은 호텔 보여줘' 같은 요청은 의도, 엔티티, 후속 문맥을 위해 파싱되어야 하는데, 이는 일반적으로 저전력 에지 칩의 능력을 훨씬 넘어서는 신경망 추론을 요구합니다.
클라우드 기반 처리는 정교한 NLP를 제공하는 계산 능력을 제공하지만 지연시간과 인터넷 연결 의존성이라는 비용이 듭니다. 에지 솔루션도 개선되고 있습니다. CEVA의 NeuPro AI 프로세서는 온디바이스 신경망 추론을 에지로 가져와 더 똑똑하고 빠른 로컬 응답을 가능하게 하면서 필요시 클라우드로 폴백합니다.
에지와 클라우드 선택은 트레이드오프를 수반합니다. 로컬 처리는 속도와 프라이버시에서 뛰어나지만 복잡한 쿼리에 어려움을 겪습니다. 클라우드 처리는 복잡한 NLP로 확장하지만 지연시간과 연결 의존성을 도입합니다.
결론
음성 인터페이스는 일상 기술의 초석이 되어가고 있습니다. 신호 처리, ASR, AI의 지속적 발전과 특화 하드웨어가 더 높은 정확도, 더 낮은 전력, 더 낮은 비용을 주도합니다.
ClearVox, WhisPro, NeuPro 같은 목적별 솔루션을 채택한 OEM은 엄격한 성능, 비용, 전력 목표를 충족하면서 시장 출시 시간을 단축할 수 있습니다.
음성 기술이 성숙함에 따라 더욱 자연스러운 상호작용과 더 넓은 애플리케이션 지평을 기대할 수 있습니다. 이는 우리가 디바이스와 소통하는 방식을 재편할 흥미로운 여정입니다.