IBM, 새로운 저정밀 AI 칩으로 25.6 TFLOPS 훈련·102.4 TOPS 추론 달성
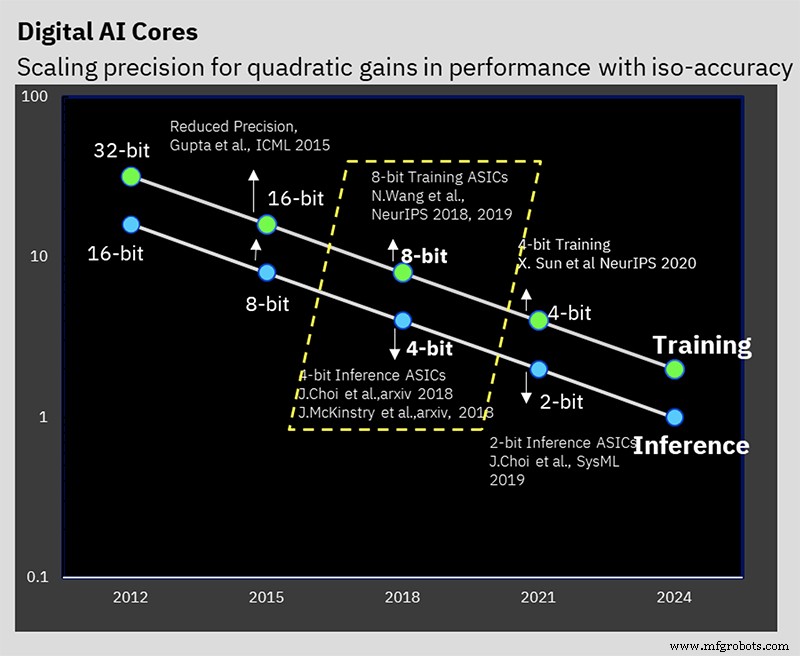
2024 ISSCC에서 IBM 리서치는 저정밀 AI 훈련과 추론에 대한 수년간 작업을 구현한 7nm 프로토타입을 공개했다. 칩은 16비트와 8비트 훈련, 4비트와 2비트 추론을 제공하며, 이는 업계 표준인 32비트 훈련/8비트 추론보다 훨씬 낮다.
수치 정밀도 저하는 연산과 전력 요구를 줄이지만, IBM은 효율을 추가로 높이는 여러 아키텍처 최적화도 도입했다. 핵심 과제는 정확도 저하 없이 정밀도를 낮추는 것인데, IBM은 알고리즘 레벨에서 수년간 이 문제를 다뤄왔다.
2019년 출범한 IBM AI 하드웨어 센터는 AI 컴퓨트 성능을 연간 2.5배 향상시켜 2029년까지 FLOPS/W 1000배 개선을 목표로 한다. 이런 야심찬 목표는 AI 모델, 특히 수조 매개변수 NLP 시스템의 폭발적 증가와 훈련 탄소 발자국 증가에 의해 주도된다.
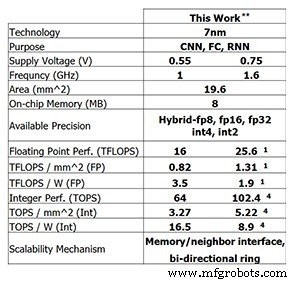
프로토타입에서 4코어 칩은 8비트 훈련 25.6 TFLOPS, 4비트 정수 추론 102.4 TOPS에 도달했다(둘 다 1.6GHz, 0.75V 측정). 클록을 1GHz, 전압을 0.55V로 낮추면 전력 효율이 3.5 TFLOPS/W(FP8) 또는 16.5 TOPS/W(INT4)로 향상된다.
IBM 리서치 테스트 칩 성능 (이미지: IBM Research) **보고된 성능은 0% 희소성 기준. (1) FP8. (4) INT4.
저정밀 훈련
이 성능은 저정밀 훈련·추론 기술에 대한 수년간 알고리즘 작업에 기반한다. 칩은 2019년 NeurIPS에서 소개된 IBM 하이브리드 FP8 포맷을 지원하는 최초 칩으로, 16비트 훈련 연산의 절반으로 8비트 훈련을 가능하게 하며 결과 저하 없이 구현한다.
IBM 리서치는 정밀도 저하하면서 정확도 유지하는 문제 해결에 매진해왔습니다 (이미지: IBM)
"저정밀 훈련은 도전적이지만 올바른 숫자 포맷으로 8비트 훈련은 달성 가능합니다."라고 IBM 펠로우이자 가속기 아키텍처·머신러닝 수석 매니저 카일라시 고팔라크리슈난(Kailash Gopalakrishnan)은 말했다. "올바른 수치 포맷을 올바른 텐서에 적용하는 것이 핵심입니다."
하이브리드 FP8은 두 포맷을 결합: 순전파(forward pass) 가중치·활성화용 하나, 역전파(backward pass) 그래디언트용 하나. 훈련은 양방향 패스 필요, 추론은 순전파 포맷만 사용.
"순전파 텐서는 더 높은 충실도(만티사 정밀도 더 필요) 필요, 그래디언트는 더 넓은 동적 범위(더 큰 지수) 필요함을 발견했습니다. 이 트레이드오프로 순전파 1-4-3(부호-지수-만티사) 분할, 역전파 5비트 지수로 232 동적 범위 확보. 하드웨어가 이제 두 변형 모두 지원합니다."
계층적 누적(Hierarchical Accumulation)
IBM의 '계층적 누적' 기법은 가중치·활성화와 함께 누적 단계에서 정밀도 저감. 전통적 FP16 훈련은 정확도 보존 위해 32비트 산술로 누적하지만 8비트 방식은 FP16으로 누적. 긴 누적을 작은 청크로 묶고 합산함으로써 칩은 하드웨어를 가볍게 유지하면서 반올림 에러 최소화.
"수천 개 숫자를 순차 더하면 정밀도 저하될 수 있습니다." 고팔라크리슈난 설명. "누적 청크화로 합을 정확하게 유지하면서 하드웨어는 가볍게."
저정밀 추론
대부분 추론 엔진이 INT8 사용하는 반면, IBM은 4비트 정수 연산이 최첨단 정확도와 매칭됨을 입증. 양자화 후 양자화 인식 훈련 단계로 정확도 손실을 0.5% 미만으로 줄여 많은 애플리케이션에 수용 가능.
온칩 링(On-Chip Ring)
칩은 딥러닝에 최적화된 네트워크온칩(NoC)을 통합해 코어 간 효율적 멀티캐스트 데이터 전송 가능. 오프칩 메모리 트래픽과 대역폭 요구 감소.
"링 동작 주파수를 코어에서 분리해 독립적 최적화와 링 롱와이어 지연 없이 더 높은 코어 속도 가능하게 했습니다."라고 머신러닝·가속기 아키텍처 리서치 스태프 안쿠르 아그라왈(Ankur Agrawal)이 말했다.
전력 관리
IBM은 워크로드 내내 칩을 전력 엔벨로프 근처에 유지하는 주파수 스케일링 방식 도입. 초기 전압과 주파수를 공격적으로 설정해 컴퓨트 집약적 단계에서 고성능 유지하고 비용 큰 전압 변경 없이 낮은 수요에 적응.
"딥러닝 워크로드는 뚜렷한 전력 피크와 골 있습니다." 아그라왈 언급. "우리 전략은 전력 소모 안정화해 골을 성능 이득으로 전환."
테스트 칩
4코어 설계는 연결 복잡성과 코어 크기 균형으로 확장 가능 아키텍처 제공. IBM은 1-2코어 칩으로 에지 디바이스, 32-64코어 칩으로 데이터센터 배포 예상, 모두 FP16, 하이브리드 FP8, INT4, INT2 가능.
"서로 다른 애플리케이션 도메인은 다른 정밀도와 에너지 트레이드오프 요구합니다." 고팔라크리슈난 말. "우리 스위스 아미 나이프 같은 포맷으로 각 유스케이스 타깃 가능하면서 효율성 타협 없음."
하드웨어 보완으로 IBM 리서치 '딥 툴즈(Deep Tools)' 컴파일러 스택 공개, 칩에서 60-90% 활용률 달성.