


사물 인터넷 기술

산업 제조
공정성은 책임 있는 인공지능의 초석입니다. 그러나 이를 정의하고 집행하는 것은 복잡한 과제로 남아 있습니다. 특히 의료, 채용, 자율주행차 같은 고위험 영역에서 기술이 사용될 때 더욱 그렇습니다.
IBM Research는 AI Fairness 360을 출시합니다. 이는 조직이 AI 시스템의 공정성을 테스트하고 검증할 수 있게 하는 클라우드 기반 편향 탐지 및 완화 서비스입니다. 이 툴킷은 데이터셋과 모델 전반의 편향을 측정하는 오픈소스 메트릭과 알고리즘 위에 구축되었습니다.
IBM Research의 펠로우인 Saska Mojsilovic에 따르면, 업계는 전통적으로 공정성보다 정확성을 우선시해 왔습니다. 그녀는 대부분의 사람들이 AI에 대해 가장 먼저 묻는 질문이 "기계가 인간을 이길 수 있는가?"라고 지적합니다. 대신 Mojsilovic은 "공정성은 어떤가?"라고 물어야 한다고 주장하며, 통제되지 않은 편향이 중요한 분야에서 파국적 결과를 초래할 수 있다고 경고합니다.
개념을 실행 가능하게 만들기 위해 IBM 팀은 공정성을 측정 가능한 구성요소로 분해하기 시작했습니다. IBM의 연구 과학자 Kush Varshney는 개인 및 그룹 수준에서 공정성을 검토했으며, 성별과 인종 같은 속성뿐만 아니라 법적, 규제적 함의도 고려했다고 설명했습니다. 그 결과 데이터, 모델, 의사결정 프로세스의 편향을 평가하는 30개의 고유한 메트릭 세트가 도출되었습니다.
AI Fairness 360 툴킷은 이러한 메트릭을 포함할 뿐만 아니라 편향을 탐지할 뿐만 아니라 모델을 디바이어스(de-bias)하는 알고리즘도 제공합니다. 목표는 개발자에게 AI 수명 주기 전반에 적용할 수 있는 실행 가능한 통찰을 제공하는 것입니다.
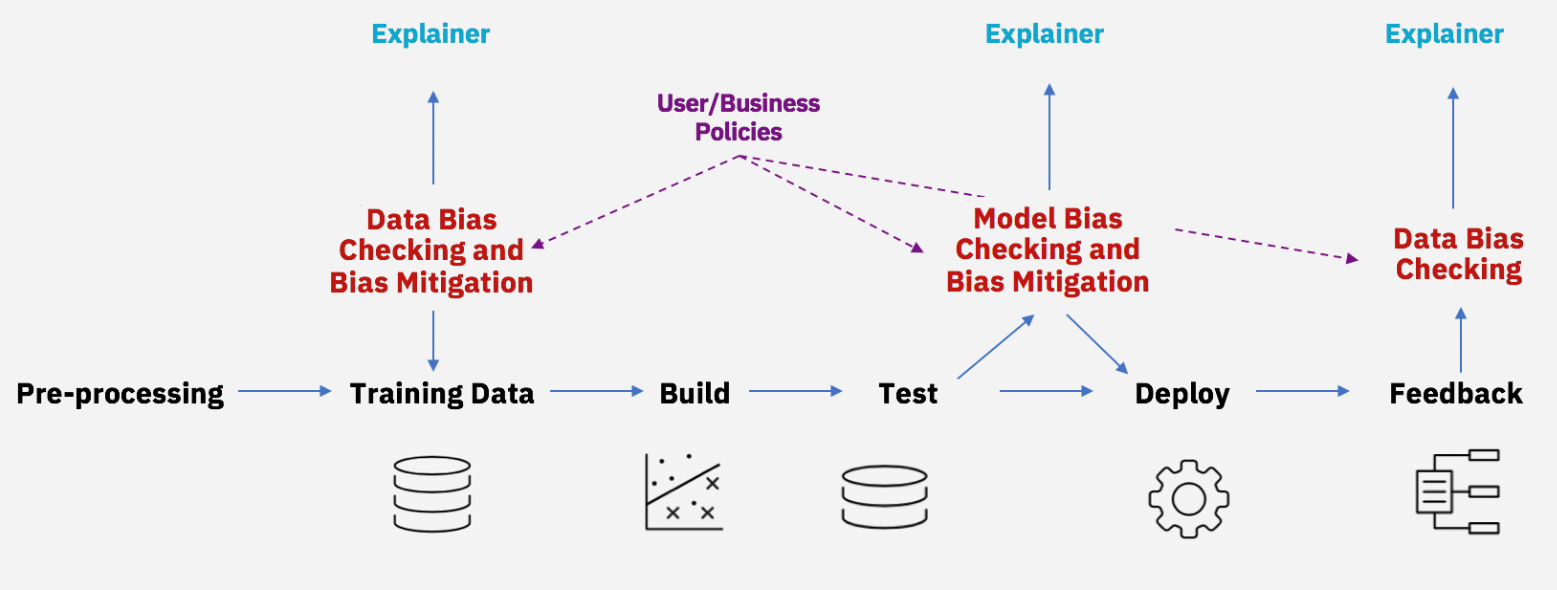
AI 수명 주기 전반의 편향 완화 (출처: IBM)
공정성이 컴퓨터 과학을 초월함을 인식한 IBM은 윤리, 법학, 사회과학 학자들과 협력했습니다. Varshney는 Uehiro-Carnegie-Oxford 윤리 컨퍼런스에서 발표했고, Mojsilovic은 UC Berkeley 로스쿨 AI 워크숍에 참여했습니다. 이들의 협업은 툴킷이 기술적 엄밀성과 사회적 가치를 모두 반영하도록 보장합니다.
위스콘신-매디슨 대학의 Young Mie Kim 같은 사회과학자들은 AI 편향이 데이터 샘플링부터 모델 훈련까지 모든 단계에서 발생할 수 있음을 지적합니다. 그녀의 연구 "알고리즘적 기회: 디지털 광고와 정치적 참여의 불평등"에서 Kim은 알고리즘 결정이 어떻게 기존 불평등을 강화할 수 있는지 보여줍니다. 그녀는 알고리즘이 "중립적"이라고 주장하는 것이 개발 및 배포 과정에서 나타나는 내재된 편향을 무시하는 것이라고 경고합니다.
투명한 메트릭과 완화 전략을 제공함으로써 AI Fairness 360은 조직이 정확할 뿐만 아니라 공평한 AI 시스템을 구축할 수 있도록 지원합니다.
사물 인터넷 기술
머신러닝(Machine Learning)은 인공지능(AI) 한 갈래로, 기계가 명시적 프로그래밍 없이 실제 데이터로부터 학습하는 기술입니다. 산업 현장에서 이 알고리즘이 주는 이점과 활용법을 살펴봅니다. 머신러닝 기초 AI 분파로, 알고리즘이 실데이터 학습 → 모델 생성 → 신규 데이터 클래스/유형 예측. 두 주요 패러다임: 지도 학습(Supervised Learning): 정답 레이블 붙은 데이터셋 필요 비지도 학습(Unsupervised Learning): 레이블 없이 데이터 특성 기반 자율 군집화·분류 핵심 역량: 패
이제 누구나 머신러닝과 그것이 모든 것을 바꿀 것이라는 이야기를 들어봤을 것입니다. 하지만 어떻게 시작해야 할지 아는 사람은 드뭅니다. 이 블로그의 단계를 따라하거나 읽어보는 것만으로도 PLCnext 컨트롤러로 머신러닝을 시작하는 방법을 이해하는 데 도움이 되길 바랍니다. 여기서는 첫 ML 모델 훈련, ONNX 표준으로 변환, PLCnext 컨트롤러에서 모델 추론까지 다룹니다. 유명한 아이리스 데이터셋을 사용해 모델을 구축하겠습니다. 머신러닝 소개 머신러닝이란? 머신러닝의 핵심은 통계와 알고리즘을 사용해 데이터셋에서 패턴을 찾는