아두이노 나노 33 BLE 센스로 TinyML 기침 감지 - 조기 독감 탐지
부품 및 소모품
| 부품 |
수량 |
| 아두이노 나노 33 BLE Sense |
1 |
앱 및 온라인 서비스
프로젝트 소개
COVID-19 및 기타 독감 관련 조기 탐지를 위한 저렴하고 쉽게 배포 가능한 솔루션에 대한 수요가 매우 큽니다. UN, Hackster, Edge Impulse 등이 공동으로 UN Covid Detect & Protect Challenge를 출범해 개발도상국의 독감 예방 및 탐지를 위한 배포 용이 솔루션 개발을 목표로 했습니다. 이 튜토리얼에서는 Edge Impulse 머신러닝을 아두이노 나노 BLE Sense에 적용해 실시간 오디오에서 기침 소리를 감지하는 방법을 보여줍니다.
기침 소리와 배경 소음 샘플 데이터셋을 구축하고, 고도로 최적화된 TinyML 모델을 적용해 20KB 미만의 RAM에서 실시간으로 동작하는 기침 감지 시스템을 나노 BLE Sense에 구현했습니다. 이 접근법은 노인 돌봄, 안전 모니터링, 기계 모니터링 등 다양한 임베디드 오디오 패턴 매칭 응용에 적용 가능합니다. 이 프로젝트와 데이터셋은 원래 Kartik Thakore가 COVID-19 대응을 위해 시작했습니다.
시작하기
필수 사항:
- 소프트웨어 개발 및 아두이노 기초 이해
- 아두이노 IDE 또는 CLI 설치
- 안드로이드 또는 iOS 스마트폰
- 아두이노 나노 BLE Sense 또는 마이크 내장 Cortex-M4+ 보드 (선택 사항)
Edge Impulse(에지 디바이스 머신러닝 온라인 개발 플랫폼)를 사용합니다. 무료 계정 생성 후 로그인하고 프로젝트 이름을 지정하세요. 예: "Arduino Cough Tutorial".
데이터셋 수집
머신러닝 프로젝트의 첫 단계는 아두이노 디바이스에서 매칭하고자 하는 알려진 데이터 샘플을 나타내는 데이터셋을 수집하는 것입니다. 10분 분량의 오디오를 "기침(cough)"과 "소음(noise)" 두 클래스로 구성한 소규모 데이터셋을 준비했습니다. 이 데이터셋을 Edge Impulse 프로젝트로 가져오거나, 직접 샘플을 추가하거나, 처음부터 새 데이터셋을 만들 수 있습니다.
주의: 본 데이터셋은 기침과 부드러운 배경 소음 샘플이 제한적이므로 실험용으로만 적절하며, 생성된 모델은 조용한 배경 소음과 제한된 범위의 기침만 구별할 수 있습니다. 더 다양한 기침, 배경 소음, 사람 말소리 등 클래스를 추가해 성능을 개선하시기 바랍니다.
중요: 억지로 기침하면 성대에 무리가 갈 수 있으니 데이터 수집과 테스트 시 주의하세요!
- 기침 데이터셋 다운로드 및 압축 해제: https://cdn.edgeimpulse.com/datasets/cough.zip
- Edge Impulse CLI Uploader로 데이터셋 가져오기:
- 데이터 획득(Data acquisition) 페이지에서 샘플 확인 및 오디오 재생 가능
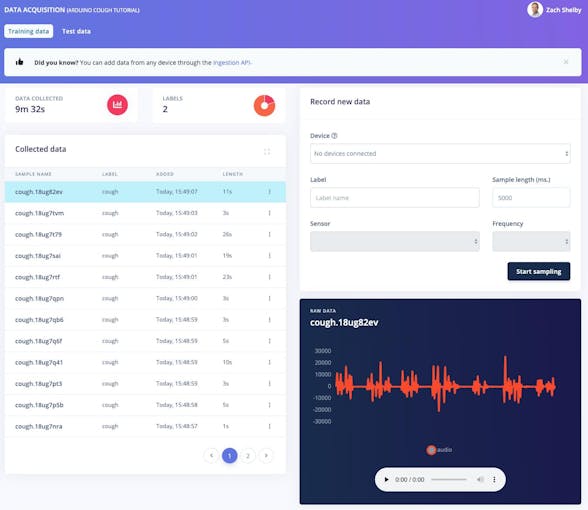
10분 분량의 기침/소음 데이터로 시작 가능. 직접 기침/배경 소음 샘플을 추가해 데이터셋 확장 가능. 데이터 획득 페이지에서 디바이스로 직접 새 데이터 수집 가능. WAV 형식 오디오 파일도 CLI Uploader로 업로드 가능.
가장 쉬운 방법: 스마트폰으로 데이터 수집 (전체 튜토리얼 여기)
- Devices 페이지 → '+ Connect a new device' → 'Use your mobile phone' 선택
- 생성된 QR 코드 촬영 후 링크 열기
- 웹 앱이 Edge Impulse 프로젝트와 연결됨
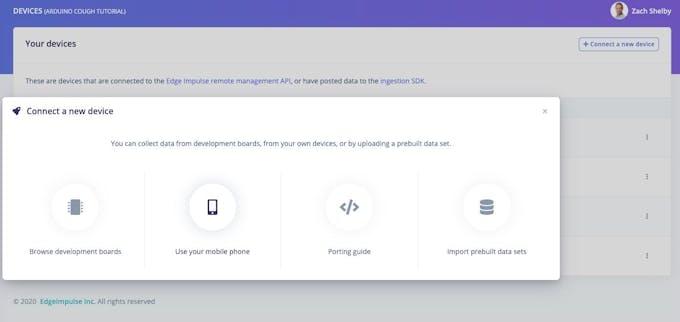
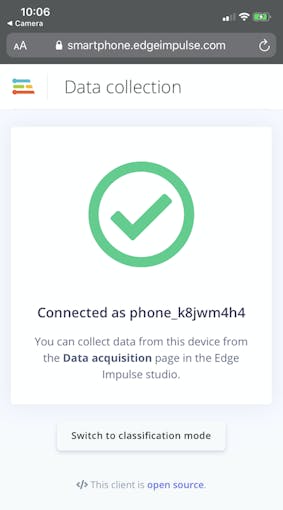
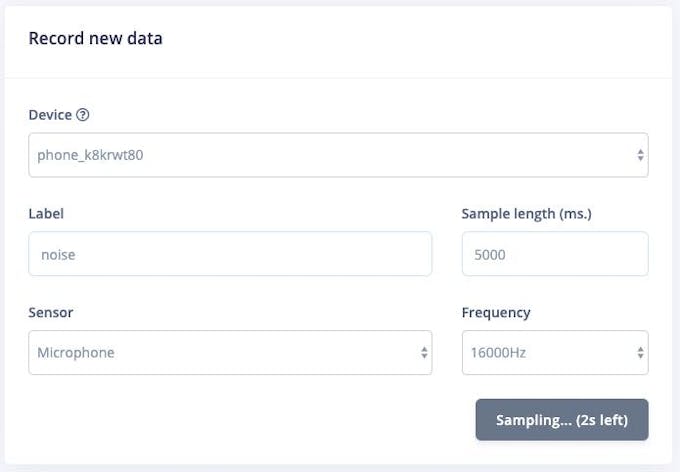
데이터 획득 페이지의 'Record new data' 섹션에서 레이블('cough' 또는 'noise') 입력, 센서 'Microphone' 선택, 'Start sampling' 클릭으로 스마트폰에서 직접 오디오 샘플 수집 및 데이터셋 추가 가능.
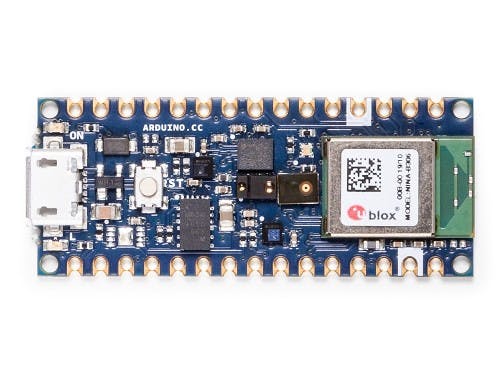
나노 BLE Sense 보드에서도 직접 데이터 수집 가능. Edge Impulse 펌웨어 및 데몬 설치 지침 따라 디바이스 연결 후 스마트폰과 동일하게 데이터 수집.
임펄스(Impulse) 생성
Create impulse 페이지에서 신호 처리와 머신러닝 블록 선택. 기본 설정인 1000ms 윈도우 크기, 500ms 윈도우 증가 유지 (오디오 데이터를 1초 단위로 처리, 0.5초마다 시작). 작은 윈도우는 임베디드 디바이스 메모리 절약하지만 기침 간 간격이 큰 샘플은 피해야 함.
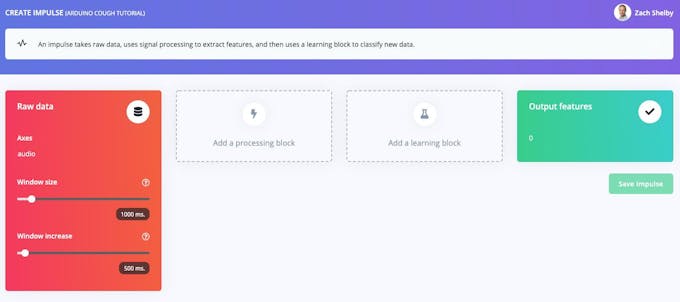
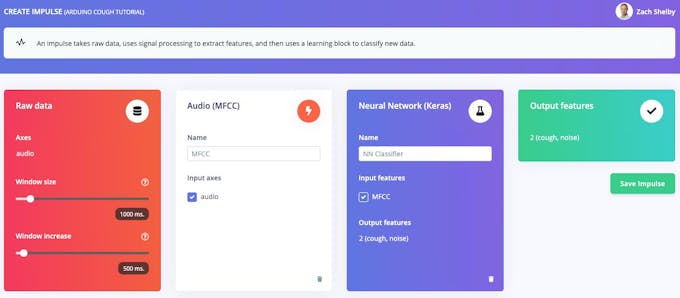
- 'Add a processing block' → Audio (MFCC) 선택
- 'Add a learning block' → Neural Network (Keras) 선택
- 'Save Impulse' 클릭
오디오 블록은 각 윈도우의 스펙트로그램 추출, 신경망 블록은 훈련 데이터셋 기반으로 스펙트로그램을 '기침' 또는 '소음'으로 분류.
MFCC 페이지에서 훈련 데이터셋으로부터 특징 생성. 각 1초 윈도우의 추출된 스펙트로그램 확인 가능. 파라미터는 기본값 유지.
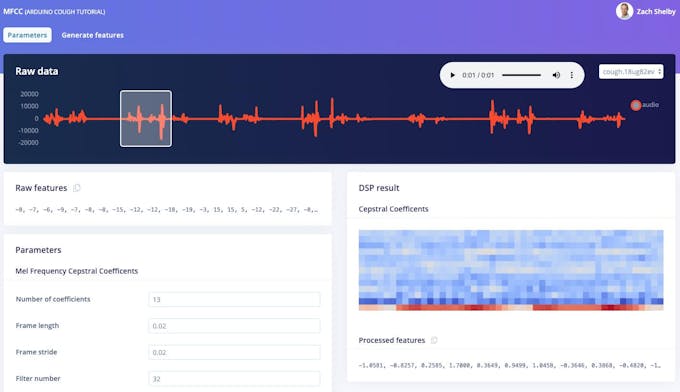
'Generate features' 버튼 클릭으로 전체 훈련 데이터셋 처리 (수 분 소요).
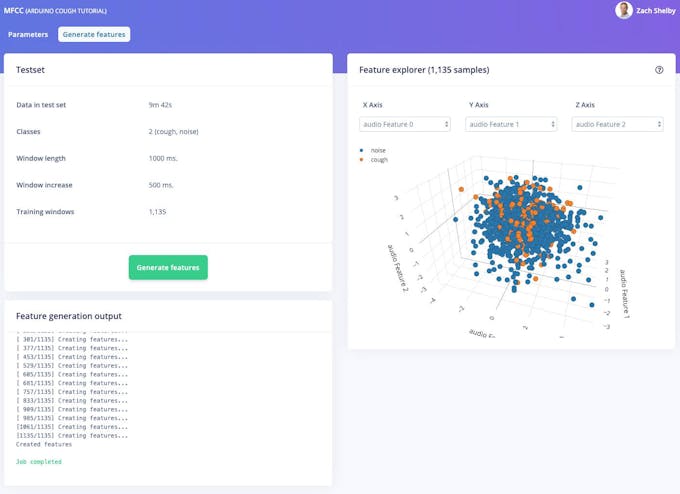
신경망 설정 및 훈련
NN Classifier 페이지에서 신경망 설정 및 훈련. 기본 신경망은 물 흐르는 소리 같은 연속 소리에 적합. 기침 감지는 더 복잡하므로 스펙트로그램 전반에 걸친 2D 컨볼루션으로 더 풍부한 네트워크 구성. 2D 컨볼루션은 이미지 분류와 유사하게 오디오 스펙트로그램 처리.
- 'Neural Network settings' 우상단 → 'Switch to Keras (expert) mode' 선택
- 'Neural network architecture'를 다음 코드로 교체하고 'Minimum confidence rating'을 '0.70'으로 설정
- 'Start training' 클릭 (수 초 소요)
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, InputLayer, Dropout, Flatten, Reshape, BatchNormalization, Conv2D, MaxPooling2D, AveragePooling2D
from tensorflow.keras.optimizers import Adam
from tensorflow.keras.constraints import MaxNorm

# 모델 아키텍처
model = Sequential()
model.add(InputLayer(input_shape=(X_train.shape[1], ), name='x_input'))
model.add(Reshape((int(X_train.shape[1] / 13), 13, 1), input_shape=(X_train.shape[1], )))
model.add(Conv2D(10, kernel_size=5, activation='relu', padding='same', kernel_constraint=MaxNorm(3)))
model.add(AveragePooling2D(pool_size=2, padding='same'))
model.add(Conv2D(5, kernel_size=5, activation='relu', padding='same', kernel_constraint=MaxNorm(3)))
model.add(AveragePooling2D(pool_size=2, padding='same'))
model.add(Flatten())
model.add(Dense(classes, activation='softmax', name='y_pred', kernel_constraint=MaxNorm(3)))

# 학습률 제어
opt = Adam(lr=0.005, beta_1=0.9, beta_2=0.999)

# 신경망 훈련
model.compile(loss='categorical_crossentropy', optimizer=opt, metrics=['accuracy'])
model.fit(X_train, Y_train, batch_size=32, epochs=9, validation_data=(X_test, Y_test), verbose=2)
훈련 성능과 온디바이스 성능 표시:
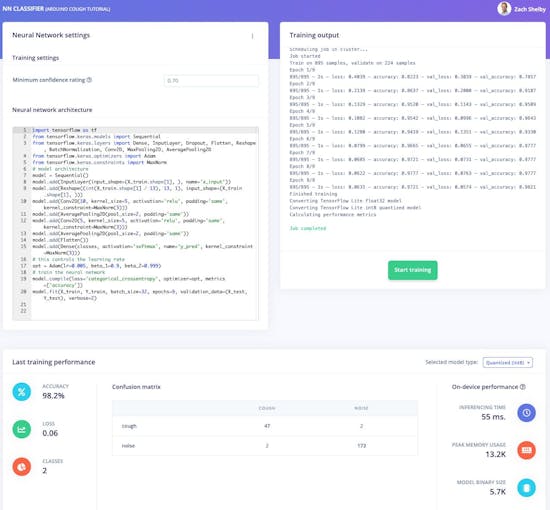
아두이노 기침 감지 알고리즘 준비 완료!
훈련 및 테스트
Live classification 페이지에서 기존 테스트 데이터나 스마트폰/아두이노 디바이스에서 스트리밍되는 오디오 데이터로 알고리즘 테스트 가능. 테스트 샘플 선택 후 'Load sample' 클릭으로 분류 결과 확인.
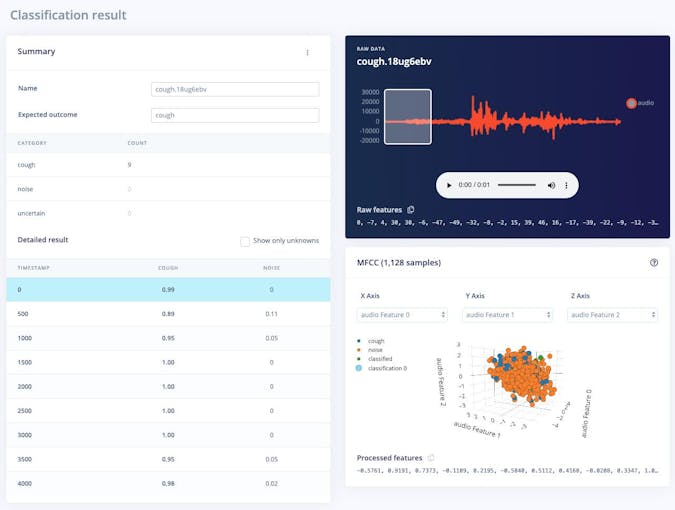
실시간 데이터 테스트: 스마트폰 브라우저 새로고침 후 'Classify new data' 섹션에서 디바이스 선택, 'Start sampling' 클릭. 나노 BLE Sense도 edge-impulse-daemon 연결 후 동일하게 테스트 가능.
배포
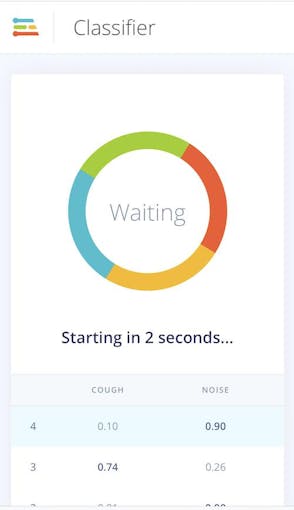
스마트폰 배포: 스마트폰 브라우저 새로고침 → 'Switch to classification mode' 버튼 클릭. WebAssembly 패키지로 빌드되어 클라우드 없이 폰에서 지속 실행 (비행기 모드에서도 작동).
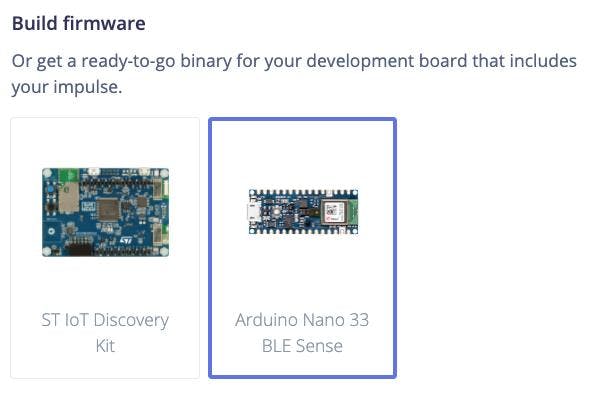
나노 BLE Sense 배포: Deployment 페이지 → 'Build firmware'에서 'Arduino Nano 33 BLE Sense' 선택 → 'Build' 클릭. 최신 알고리즘 포함 완전한 펌웨어 빌드. 화면 지시에 따라 아두이노 보드에 바이너리 플래싱.
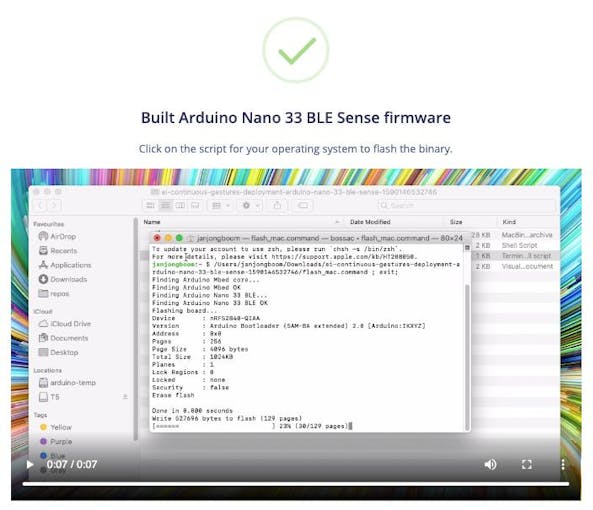
플래싱 완료 후 시리얼 포트 열기 (115,200 보드레이트). 엔터 키 눌러 프롬프트 진입 후:
> AT+RUNIMPULSE
Inferencing settings:
 Interval: 0.06 ms.
 Frame size: 16000
 Sample length: 1000 ms.
 No. of classes: 2
Starting inferencing, press 'b' to break
Recording...
Recording done
Predictions (DSP: 495 ms., Classification: 84 ms., Anomaly: 0 ms.):
 cough: 0.01562
 noise: 0.98438
Starting inferencing in 2 seconds...
Recording...
Recording done
Predictions (DSP: 495 ms., Classification: 84 ms., Anomaly: 0 ms.):
 cough: 0.86719
 noise: 0.13281
Starting inferencing in 2 seconds...
Recording...
Recording done
Predictions (DSP: 495 ms., Classification: 84 ms., Anomaly: 0 ms.):
 cough: 0.01562
 noise: 0.98438
향후 과제
TinyML, 센서, Edge Impulse, 아두이노의 가능성은 무궁무진합니다. 추가 아이디어:
- 자체 기침 소리와 배경 소리로 기본 데이터셋 확장, 주기적 재훈련 및 테스트. Testing 페이지에서 단위 테스트 설정으로 모델 검증
- 기침이 아닌 사람 소리(배경 대화, 하품 등) 클래스 및 데이터 추가
- 새 데이터셋으로 완전히 새로운 것 감지 시작. 힌트: 이 데이터셋의 소음 클래스 데이터만 업로드해 시작 가능!
- 아두이노 라이브러리로 배포해 스케치에 포함, LED나 디스플레이로 기침 감지 표시
- 나노 BLE Sense의 3축 가속도계 등 다른 센서 활용 (튜토리얼 참조)



