파이토치(PyTorch) vs 텐서플로우(TensorFlow): 딥러닝 프레임워크 선택 전문가 가이드
딥러닝의 인기 상승으로 딥러닝 프레임워크 간 건전한 경쟁이 생겼습니다. 파이토치(PyTorch)와 텐서플로우(TensorFlow)는 가장 인기 있는 두 딥러닝 프레임워크로 떠오르고 있습니다. 두 라이브러리는 주요 딥러닝 도구가 되기 위해 정면으로 경쟁하고 있습니다.
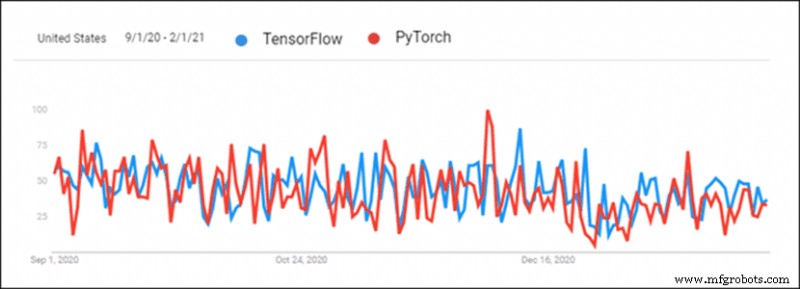
텐서플로우는 더 오래되어 이 때문에 항상 선두였지만, 파이토치는 지난 6개월간 따라잡았습니다. 프로젝트에 적합한 딥러닝 프레임워크를 선택할 때 올바른 선택을 두고 많은 혼란이 있습니다.
이 기사는 파이토치 vs 텐서플로우를 비교하고 두 프레임워크에 대한 심층 비교를 제공합니다.
파이토치 vs 텐서플로우: 개요
파이토치와 텐서플로우 모두 경쟁사가 무엇을 하는지 주시합니다. 그러나 여전히 두 프레임워크 간에는 몇 가지 차이가 있습니다.
참고: 이 표는 가로로 스크롤 가능합니다.
| 라이브러리 |
파이토치 |
텐서플로우 2.0 |
| 개발 주체 |
FAIR Lab (페이스북 AI 연구소) |
구글 브레인 팀 (Google Brain Team) |
| 기반 |
Torch |
Theano |
| 프로덕션 |
연구 중심 |
산업 중심 |
| 시각화 |
Visdom |
TensorBoard |
| 배포 |
TorchServe (실험적) |
TensorFlow Serving |
| 모바일 배포 |
가능 (실험적) |
가능 |
| 디바이스 관리 |
CUDA |
자동화 |
| 그래프 생성 |
동적 및 정적 모드 |
즉시 실행(Eager) 및 정적 모드 |
| 학습 곡선 |
개발자와 과학자에게 더 쉬움 |
산업 수준 프로젝트에 더 쉬움 |
| 사용 사례 |
페이스북, CheXNet, 테슬라 오토파일럿, 우버, PYRO |
구글, 시노베이션 벤처스, 페이팔, 차이나 모바일 |
1. 시각화 (Visualization)
수동 시각화는 시간이 걸립니다. 파이토치와 텐서플로우 모두 빠른 시각 분석을 위한 도구를 제공합니다. 이는 훈련 과정 검토를 쉽게 만듭니다. 시각화는 결과 프레젠테이션에도 훌륭합니다.
텐서플로우
데이터 시각화에 텐서보드(TensorBoard)를 사용합니다. 인터페이스는 인터랙티브하고 시각적으로 매력적입니다. 텐서보드는 지표와 훈련 데이터에 대한 자세한 개요를 제공합니다. 데이터는 쉽게 내보낼 수 있고 프레젠테이션용으로 보기 좋습니다. 플러그인으로 파이토치에서도 텐서보드를 사용할 수 있습니다.
그러나 텐서보드는 번거롭고 사용이 복잡합니다.
파이토치
파이토치는 비즈돔(Visdom)을 시각화에 사용합니다. 인터페이스는 가볍고 사용하기 간단합니다. 비즈돔은 유연하고 커스터마이징 가능합니다. 파이토치 텐서에 대한 직접 지원으로 사용이 간편합니다.
비즈돔은 인터랙티브함이 부족하고 데이터 개요를 위한 많은 필수 기능이 없습니다.
2. 그래프 생성 (Graph Generation)
신경망 아키텍처 생성에는 두 가지 유형이 있습니다:
- 정적 그래프 (Static graphs) – 고정된 계층 아키텍처. 맵이 먼저 생성되고 데이터가 통과됩니다.
- 동적 그래프 (Dynamic graphs) – 동적 계층 아키텍처. 데이터 오버로딩으로 맵이 암시적으로 정의됩니다.
텐서플로우
텐서플로우는 처음부터 정적 그래프를 사용했습니다. 정적 그래프는 여러 머신에 분산 가능합니다. 모델은 코드와 독립적으로 배포됩니다. 정적 그래프 사용은 텐서플로우를 더 프로덕션 친화적으로 만들고 새로운 아키텍처 작업 시 유연하게 만들었습니다.
텐서플로우는 즉시 실행(eager execution)이라는 동적 그래프를 모방하는 기능을 추가했습니다. 텐서플로우 2는 기본적으로 즉시 실행으로 작동합니다. 즉시 실행을 끄면 정적 그래프 생성을 사용할 수 있습니다.
파이토치
파이토치는 처음부터 동적 그래프를 특징으로 했습니다. 이 기능이 파이토치를 텐서플로우와 경쟁하게 만들었습니다.
그래프를 즉석에서 변경할 수 있는 능력은 신경망 생성에 더 프로그래머 및 연구자 친화적인 접근 방식임이 입증되었습니다. 구조화된 데이터와 데이터의 크기 변화는 동적 그래프로 더 쉽게 처리할 수 있습니다. 파이토치는 정적 그래프도 제공합니다.
3. 학습 곡선 (Learning Curve)
학습 곡선은 이전 경험과 딥러닝 사용의 최종 목표에 따라 다릅니다.
텐서플로우
텐서플로우는 더 어려운 라이브러리입니다. 케라스(Keras) 기능이 텐서플로우를 더 쉽게 만듭니다. 일반적으로 딥러닝을 막 시작하는 사람에게 텐서플로우는 이해하기 어렵습니다.
이유는 텐서플로우의 다양한 기능 때문입니다. 탐색하고 파악해야 할 기능이 많습니다. 이는 초보자에게 산만하고 중복됩니다.
파이토치
파이토치는 더 배우기 쉬운 라이브러리입니다. 파이썬이 익숙하다면 코드로 실험하기 더 쉽습니다. 파이토치에서 신경망을 생성하는 파이썬다운(Pythonic) 접근 방식이 있습니다. 파이토치의 유연성은 코드를 실험 친화적으로 만듭니다.
파이토치는 기능이 덜 풍부하지만 모든 필수 기능은 있습니다. 파이토치는 시작하고 배우기 더 간단합니다.
4. 배포 (Deployment)
배포는 소프트웨어 개발 팀에게 중요한 소프트웨어 개발 단계입니다. 소프트웨어 배포는 프로그램이나 애플리케이션을 소비자 사용이 가능하게 만듭니다.
텐서플로우
텐서플로우는 모델 배포에 텐서플로우 서빙(TensorFlow Serving)을 사용합니다. 텐서플로우 서빙은 프로덕션과 산업 환경을 염두에 두고 설계되었습니다. 배포는 REST 클라이언트 API로 유연하고 고성능입니다. 텐서플로우 서빙은 도커(Docker)와 쿠버네티스(Kubernetes)와 잘 통합됩니다.
파이토치
파이토치는 최근 배포 문제를 다루기 시작했습니다. 토치 서브(TorchServe)가 파이토치 모델을 배포합니다. 애플리케이션 통합을 위한 RESTful API가 있습니다. 파이토치 API는 모바일 배포를 위해 확장 가능합니다. 토치 서브는 쿠버네티스와 통합됩니다.
5. 병렬 처리와 분산 훈련 (Parallelism and Distributed Training)
병렬 처리와 분산 훈련은 빅데이터에 필수적입니다. 일반적인 지표는:
- 속도 증가 – 순차 모델 속도(단일 GPU) 대비 병렬 모델 속도(다중 GPU) 비율
- 처리량 (Throughput) – 단위 시간당 모델을 통과하는 최대 이미지 수
- 확장성 (Scalability) – 시스템이 작업량 증가를 어떻게 처리하는지
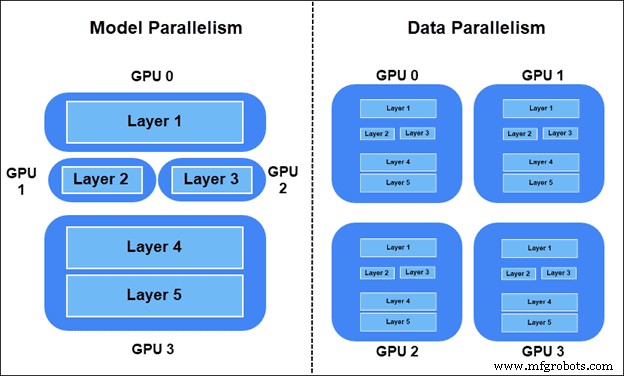
훈련 워크로드를 분산하는 두 가지 방법:
- 모델 병렬 처리 (Model parallelism) – 모델의 계층을 다른 디바이스로 분할. 그래프의 일부가 동시에 훈련에 사용됨.
- 데이터 병렬 처리 (Data parallelism) – 모든 디바이스가 전체 모델의 복사본을 가짐. 각 디바이스가 다른 데이터 샘플로 훈련. 동기식 SGD(Stochastic Gradient Descent) 방식 선호.
텐서플로우 모델 병렬 처리
텐서플로우에서 모델의 일부를 특정 디바이스에 배치하려면 tf.device를 사용합니다.
예: 두 선형 계층을 두 개의 다른 GPU 디바이스로 분할:
import tensorflow as tf
from tensorflow.keras import layers
with tf.device('GPU:0'):
    layer1 = layers.Dense(16, input_dim=8)
with tf.device('GPU:1'):
    layer2 = layers.Dense(4, input_dim=16)
파이토치 모델 병렬 처리
파이토치에서 모델의 일부를 다른 디바이스로 이동하려면 nn.Module.to 메서드를 사용합니다.
예: 두 선형 계층을 두 개의 다른 GPU로 이동:
import torch.nn as nn
layer1 = nn.Linear(8,16).to('cuda:0')
layer2 = nn.Linear(16,4).to('cuda:1')
텐서플로우 데이터 병렬 처리
텐서플로우에서 동기식 SGD를 하려면 tf.distribute.MirroredStrategy()로 분산 전략을 설정하고 모델 초기화를 래핑합니다:
import tensorflow as tf
strategy = tf.distribute.MirroredStrategy()
with strategy.scope():
    model = ...
    model.compile(...)
래퍼로 모델을 컴파일한 후 평소대로 모델을 훈련합니다.
파이토치 데이터 병렬 처리
파이토치에서 동기식 SGD를 하려면 모델 초기화 후 torch.nn.DistributedDataParallel로 모델을 래핑하고 디바이스 번호 순위를 0부터 시작하여 설정합니다:
from torch.nn.parallel import DistributedDataParallel
model = ...
model = model.to()
ddp_model = DistributedDataParallel(model, device_ids=[])
6. 디바이스 관리 (Device Management)
디바이스 관리 시 성능에 큰 변화가 발생합니다. 파이토치와 텐서플로우 모두 신경망을 잘 적용하지만 실행 방식은 다릅니다.
텐서플로우
GPU가 사용 가능하면 텐서플로우는 자동으로 GPU 사용으로 전환합니다. GPU와 접근 방식에 대한 제어권이 있습니다. GPU 가속이 자동화됩니다. 이는 메모리 사용에 대한 제어권이 없음을 의미합니다.
파이토치
파이토치는 GPU 또는 CPU 사용을 지정하기 위해 CUDA를 사용합니다. GPU와 CPU 사용에 대한 CUDA 사양 없이는 모델이 실행되지 않습니다. GPU 사용이 자동화되지 않아 리소스 사용에 대한 더 나은 제어가 가능합니다. 파이토치는 GPU 제어를 통해 훈련 과정을 향상시킵니다.
7. 두 딥러닝 플랫폼의 사용 사례 (Use Cases)
텐서플로우와 파이토치는 각자 회사에서 처음 사용되었습니다. 오픈소스가 된 이후 구글과 페이스북 외부에서도 많은 사용 사례가 생겼습니다.
텐서플로우
구글 브레인 팀의 구글 연구자들이 텐서플로우를 구글 연구 프로젝트에 처음 사용했습니다. 구글은 텐서플로우를 다음에 사용합니다:
- 검색 결과 및 자동완성
- 음성-텍스트 변환 및 음성 기술
- 이미지 인식 및 분류
- 기계 번역 시스템
- 지메일(Gmail) 스팸 탐지
구글 외부에도 많은 사용 사례가 있습니다. 예:
- 시노베이션 벤처스 (Sinovation Ventures) – 망막 이미지를 사용한 질병 분류 및 세분화
- 페이팔 (PayPal) – 딥 전이 학습과 생성 모델링을 이용한 사기 탐지
- 차이나 모바일 (China Mobile) – 네트워크 문제 탐지, 자동 컷오버 시간 창 예측, 운영 로그 검증을 위한 딥러닝 시스템
파이토치
파이토치는 페이스북 AI 연구원 랩(FAIR)에서 페이스북에서 처음 사용되었습니다. 페이스북은 파이토치를 다음에 사용합니다:
- 얼굴 인식 및 객체 탐지
- 스팸 필터링 및 가짜 뉴스 탐지
- 뉴스피드 자동화 및 친구 추천 시스템
- 음성 인식
- 기계 번역 시스템
파이토치는 오픈소스입니다. 이제 페이스북 외부에서도 많은 사용 사례가 있습니다:
- CheXNet – 합성곱 신경망을 사용한 폐렴 확률 점수 및 흉부 X-레이 히트맵
- 테슬라 오토파일럿 (Tesla Autopilot) – 자율 주행 차량을 위한 실시간 컴퓨터 비전 멀티태스킹
- 우버 AI 랩 PYRO – 딥 확률적 모델링을 위한 확률적 프로그래밍 언어. 고객-드라이버 매칭 최적화, 최적 경로, 차세대 지능형 차량 예측 및 최적화
파이토치를 쓸까, 텐서플로우를 쓸까?
파이토치는 프로그래머와 과학 연구자들 사이에서 선호되는 옵션입니다. 인용 수를 볼 때 과학계는 파이토치를 선호합니다. 최근 배포 및 프로덕션 기능으로 파이토치는 연구에서 프로덕션으로 갈 때 훌륭한 옵션입니다.
조직과 스타트업은 일반적으로 텐서플로우를 사용합니다. 배포 및 프로덕션 기능이 텐서플로우에 엔터프라이즈 사용 사례에서 좋은 평판을 줍니다. 텐서보드 시각화는 고객에게 우아한 프레젠테이션을 보여줍니다.
파이토치와 텐서플로우는 강렬하게 발전하는 강력한 딥러닝 라이브러리입니다. 오늘날 두 프레임워크 간에는 차이점보다 유사점이 더 많으며, 하나를 다른 것으로 전환하는 것은 매끄러운 과정입니다.



