클라우드 장애 이해: 원인, 영향, 예방 전략
IT가 클라우드 서비스에 더 많이 의존할수록 클라우드 장애로 인한 다운타임과 수익 손실 가능성이 커집니다. 퍼블릭 클라우드를 사용하는 조직의 60% 이상이 2022년 이러한 사고로 인한 손실을 보고했으므로, 장애는 기업이 직면할 가능성이 낮은 기이한 현상이 아닙니다.
하지만 장애가 클라우드를 영원히 떠날 충분한 이유일까요? 아니면 가끔 발생하는 다운타임 위험에도 불구하고 이 인프라 유형을 유지해야 할까요?
이 글은 클라우드 장애에 대해 알아야 할 모든 것을 다룹니다. 주요 원인을 개요하고, 눈을 뜨게 하는 통계를 살펴보며, 클라우드 다운타임의 영향을 최소화하는 방법을 보여주고, 최근 몇 년간 발생한 가장 영향력 있는 장애 사례들을 살펴봅니다.
클라우드 장애란 무엇인가?
클라우드 장애는 클라우드 제공업체의 서비스가 최종 사용자에게 제공되지 않는 기간입니다. 벤더의 인프라가 다운되고(버그, 정전 등), 클라이언트는 제공업체가 문제를 해결할 때까지 클라우드 기반 자산에 접근할 수 없게 됩니다.
영향 측면에서 온사이트 데이터 센터 다운과 클라우드 장애는 차이가 없습니다. 두 경우 모두 IT 자산에 대한 접근을 잃지만, 클라우드 컴퓨팅의 핸즈오프 접근 방식은 몇 가지 독특한 고려사항을 추가합니다:
- 클라우드 장애는 장애 가시성이 거의 없거나 전혀 없어 사용자는 일반적으로 무엇이 잘못되었는지 모릅니다.
- 제공업체 팀이 오류 수정을 책임지므로 클라이언트는 복구 프로세스에 참여하지 않습니다.
- 문제에 대한 가시성이나 제어권이 없으므로 서비스가 언제 다시 온라인 상태가 될지 알 수 없습니다.
로컬 하드웨어와 마찬가지로 클라우드 장애에는 두 가지 유형이 있습니다:
- 계획된 장애(일반적으로 예정된 유지보수로 인해 발생)
- 계획되지 않은 장애(제공업체가 예상치 못한 오류에 직면하여 복구 조치를 수행해야 할 때 발생)
최근 연구에 따르면 계획되지 않은 장애는 계획된 다운타임보다 35% 더 많은 비용이 듭니다(온프레미스와 클라우드 모두). 가격 차이는 예상치 못한 사고가 식별하고 수정하는 데 더 오래 걸리기 때문이며, 장애가 길어질수록 피해가 커집니다.
온사이트 하드웨어와 비교할 때, 클라우드 기반 인프라는 더 빈번한 다운타임을 초래하지만 심각도는 낮습니다. 어떤 호스팅 시스템도 100% 가동 시간을 제공하지 않으므로, 클라이언트는 클라우드 컴퓨팅 이점을 대가로 가끔 발생하는 장애를 감수할 의향이 있습니다. 이러한 의향은 시장 성장에서도 드러납니다. 클라우드는 2024년 전 세계 IT 지출의 14.2%를 차지할 것입니다(2020년 9.1%에서 증가).
클라우드 장애 원인
클라우드 장애는 제공업체의 통제가능 범위 내외의 여러 원인에서 기인합니다. 가장 일반적인 원인 목록은 다음과 같습니다:
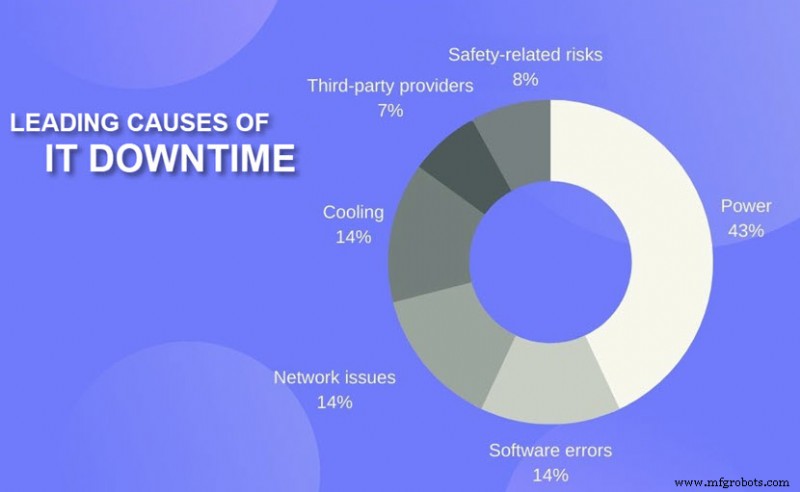
- 정전: 전력 관련 이슈가 상당한 다운타임과 재정적 손실을 동반하는 모든 클라우드 장애의 43%를 차지합니다. 무정전 전원 장치(UPS) 장애가 전력 사고의 1위 원인입니다.
- 사이버 보안: DDoS(Distributed Denial of Service)와 같은 사이버 공격이 데이터 센터에 들어오는 트래픽을 과부하시킵니다. 이 경우 최종 사용자는 동일한 네트워킹 인프라를 통해 서비스에 접근할 수 없습니다. 랜섬웨어나 SQL 인젝션 같은 다른 위협은 제공업체가 서비스를 중단하고 오프라인에서 문제를 해결하도록 강제할 수 있습니다.
- 인적 오류: 단 하나의 잘못된 명령이나 케이블링 실수가 전체 IT 인프라를 다운시킬 수 있습니다. 인적 오류는 장애로 이어지는 물리적 및 소프트웨어 이슈를 모두 유발합니다.
- 기술적 문제: 클라우드 서비스는 복잡한 하드웨어 기술 시스템에 의존하므로, 레이더 아래에 충분히 오래 머무르는 오류가 클라우드 장애로 이어질 수 있습니다.
- 소프트웨어 버그: 글리치와 버그는 클라우드 데이터 센터에서 흔합니다. 일반적인 원인은 데이터 형식 버그, 결함 관련 버그, 타이밍 버그, 상수 값 버그입니다.
- 네트워킹 이슈: 네트워크 통신 및 서드파티 통신사 파트너와 관련된 이슈도 클라우드 장애의 일반적인 원인입니다.
- 유지보수: 예정된 유지보수와 시스템 업그레이드가 때때로 장애를 초래하지만, 최종 사용자는 일반적으로 이러한 발생을 사전에 알고 있습니다.
- 환경적 원인: 허리케인, 화재, 번개 폭풍, 지진 같은 이벤트도 시설이 위험에 처하거나 지역 전력망을 손상시켜 클라우드 다운타임을 유발합니다.
- 더 복잡한 배포: 더 복잡한 배포 모델(하이브리드, 분산, 멀티클라우드 등)은 데이터 센터 운영을 복잡하게 만들어 오류 발생 기회를 더 많이 만듭니다.
클라우드가 다운되면 무슨 일이 일어나는가?
최상의 시나리오에서는 클라우드 장애가 몇 분만 지속되고 소수의 사용자나 서비스에 영향을 미칩니다. 최악의 경우 장애가 반나절 이상 비즈니스를 마비시킵니다. 기업은 모든 클라우드 기반 자산에 대한 접근을 잃고 장애가 끝날 때까지 차단된 상태로 남습니다.
위협적이지만, 서드파티 제공업체의 실수가 2021년 심각한 장애의 '단 7%' 원인이었습니다. 심각한 장애에는 다음 중 하나(또는 여러 개)가 포함되어야 합니다:
- 상당한 재정적 손실
- 평판 손상
- 규정 준수 위반
- 인명 손실
아래 도넛 차트에서 볼 수 있듯이 더 시급한 우려사항이 있지만, 평균 다운타임 1분당 비용은 $5,600입니다(엔터프라이즈의 경우 분당 $9,000). 준비되지 않은 상태(데이터 백업, 재해 복구 등 없음)라면 클라우드 장애가 서비스를 중단시키고 수익에 막대한 타격을 줄 수 있습니다.
운영의 작은 부분만 클라우드에 두는 기업은 장애에 덜 취약합니다. 예를 들어 이메일만 클라우드에 호스팅하는 경우, 하루 종일 지속되는 장애도 치명적이지 않습니다. 사고가 지나가길 기다리거나 축소된 기능으로 앱을 실행할 수 있습니다. 이는 IoT 플랫폼 실행이나 결제 처리에 클라우드를 사용하는 경우 작동하지 않는 전략입니다.
일부 경우 클라우드 장애가 영구적인 데이터 손실로 이어집니다(손실된 데이터 양은 백업 빈도에 따라 다름). 또한 엄격한 산업의 클라이언트는 장애가 데이터 유출이나 누수로 이어질 경우 법적 벌금에 책임이 있으므로, 클라우드 스토리지에 무엇을 보관할지 결정할 때 주의해야 합니다.
사용자가 할 수 있는 일은?
기업들이 클라우드 장애의 영향을 완화하기 위해 하는 일은 다음과 같습니다:
- 단일 장애 지점 제거: 모든 미션 크리티컬 IT 구성 요소의 백업을 온사이트 서버 룸이나 보조 제공업체에 준비하세요. 클라우드가 다운되면 페일오버(대기 서버, 하드웨어 구성 요소, 네트워크 등으로 전환하는 프로세스)를 수행하여 비즈니스 연속성을 보장하세요.
- 비상 계획 수립: 재해 복구 계획은 장애 발생 시 팀이 수행할 단계별 전략을 설명합니다. 이 계획은 데이터 보호, 페일오버 수행, 비즈니스 연속성 보장, 운영 복원에 대한 지침을 제공합니다. 클라우드 장애에 대한 적시 계획은 다운타임 동안 최선의 행동 방침을 평가하는 데 시간을 낭비하지 않게 합니다.
- 더 높은 가용성 SLA 투자: 비즈니스 크리티컬 작업이 긴 클라우드 장애를 감당할 수 없다면, 99.999% 가동 시간 보장(연간 최대 5.25분 다운타임) 같은 더 높은 가용성 서비스 수준 계약(SLA)을 찾으세요. 이러한 계약은 더 비싸지만, 서비스 온라인 유지가 클라우드 제공업체에게 더 큰 우선순위가 됩니다.
- 정기적인 데이터 백업 수행: 백업은 클라우드 장애가 데이터베이스를 손상시키거나 삭제할 경우 팀이 파일의 최신 버전을 복원할 방법을 보장합니다. 이상적으로 백업은 미션 크리티컬성에 따라 시간당 1회에서 일일 1회 사이에 자동으로 발생해야 합니다.
- 장애 최대한 빨리 감지: 팀이 설정하는 추가 클라우드 모니터링 역량은 제공업체 알림을 기다리는 대신 실시간으로 장애를 식별하는 데 도움이 됩니다. 다운타임 감지 개선과 적시 페일오버 보장을 위한 최고의 클라우드 모니터링 도구 목록을 확인하세요.
최근 주요 클라우드 장애 사례
클라우드 장애는 클라우드 사용 시 피할 수 없으며, 가장 인기 있는 제공업체(Azure, AWS, Google Cloud)도 다운타임에서 자유롭지 않습니다. 최근 역사상 가장 중요한 클라우드 장애 몇 가지를 살펴보겠습니다.
Azure 장애 (2021년 10월)
2021년 10월, Microsoft Azure는 가상 머신 서비스를 6시간 동안 중단시킨 장애를 겪었습니다. 장애 기간 동안 많은 사용자가 새 VM을 배포하거나 확장을 업데이트할 수 없었습니다. 시작, 생성, 삭제와 같은 기본 서비스 관리 작업도 오류를 초래했습니다.
클라우드 장애의 원인은 VM 쿼리가 아티팩트의 필수 버전 데이터를 검색할 수 없었던 것입니다. 사후 복구 보고서에 따르면 소프트웨어 기반 실수는 Microsoft가 VM 아키텍처 중 하나를 마이그레이션할 때 발생했습니다.
Google Cloud 장애 (2021년 11월)
Google Cloud는 작년 11월 중순 약 2시간 동안 다운되었으며, 다음에 영향을 미쳤습니다:
- Home Depot
- Snapchat
- Etsy
- Discord
- Spotify
영향을 받은 웹사이트는 방문자가 접근하려 할 때 404 오류를 표시했습니다. Google은 클라우드 장애 원인이 로드 밸런싱을 담당하는 네트워크 구성의 글리치였다고 보고했습니다.
AWS 장애 (2021년 12월)
대규모 연결 활동 급증이 AWS 플래그십 시설 중 하나의 네트워킹 장치를 압도하여 다양한 웹사이트와 앱에 영향을 미쳤습니다. 가장 주목할 만한 '피해자'는 다음과 같습니다:
- Amazon 웹사이트
- Prime Video
- Netflix
- IMDb
- PlayStation Network
데이터 센터 이슈로 내부 AWS 네트워크 내에서 심각한 지연이 발생했습니다. 고객 앱은 파급 효과를 느껴 약 7시간 동안 트래픽 지연이나 완전한 종료를 겪었습니다.
연이은 두 번의 IBM 장애 (2022년 1월)
IBM 인프라 이슈로 달라스 지역의 클라우드 서비스가 5시간 이상 영향을 받았습니다. 내부 팀이 문제를 해결했지만 실수로 전 세계 사용자(미국, 일본, 캐나다, 독일 포함)에게 추가 1시간 동안 가상 프라이빗 클라우드 이슈를 유발했습니다.
AWS/Slack 장애 (2022년 2월)
Slack은 2월 AWS 클라우드 리소스 장애로 통신 플랫폼의 정상 사용이 5시간 동안 차단되었습니다. 11,000명 이상의 신고 사용자가 다음을 할 수 없었습니다:
- 메시지 보내기 또는 받기
- 파일 업로드
- 채널 참여
- 데스크톱 앱 실행
Slack 팀은 클라우드 장애 원인을 결코 공유하지 않았고, 복구 후 모든 영향을 받은 사용자에게 앱 재시작과 캐시 삭제를 요청했습니다.
iCloud 장애 (2022년 3월)
15개 주요 Apple 서비스가 클라우드 장애로 4시간 동안 다운되었으며, 다음이 포함됩니다:
- App Store
- Apple Maps
- Apple TV
Apple의 기업 및 소매 시스템도 다운되었습니다. 회사는 나중에 근본 원인이 회사의 도메인 네임 시스템(DNS) 관련 문제였다고 밝혔습니다.
Google Cloud 장애 (2022년 3월)
2022년 3월 8일, Google Cloud 사용자들은 2시간 30분 동안 서비스 오류를 겪었습니다. Spotify와 Discord가 장애의 영향을 받은 기업들 중 하나였습니다.
구성 처리를 위한 Traffic Director 코드 변경이 오류를 유발했습니다. 사후 복구 보고서에 따르면 잘못된 코드 변경이 구성 데이터 형식 마이그레이션을 소홀히 하여 플랫폼이 사용자의 프로그래밍을 의도치 않게 삭제했습니다.
Atlassian 장애 (2022년 4월)
올해 최대 Atlassian 장애는 4월 5일 시작되어 4월 18일 끝났습니다(일부 사용자는 4월 8일부터 서비스 복구 시작). 회사는 부적절한 팀 커뮤니케이션과 잘못 계획된 인시던트 대응 계획 때문에 장애가 발생했다고 설명했습니다.
이 클라우드 장애가 일부 사용자에게 거의 2주 동안 지속되었지만, 클라이언트 데이터의 상당한 손실 보고는 없었습니다. 그러나 Atlassian의 플래그십 제품인 Trello와 Jira 사용자 모두 이슈의 영향을 받았습니다.
Microsoft Azure 장애 (2022년 6월)
6월 7일, Azure 고객들은 East US 2 리전(주로 버지니아)에 호스팅된 리소스에 연결할 수 없었습니다. 장애는 약 12시간 지속되었으며 존 중복 인프라에 의존하는 소비자들에게는 영향을 미치지 않았습니다. 영향을 받은 서비스에는 다음이 포함됩니다:
- Application Insights
- Log Analytics
- Managed Identity Service
- Media Services
- NetApp Files
원인은 로컬 데이터 센터 중 한 곳의 갑작스러운 전력 진동으로, 공기 처리 장치(AHU)가 중단되었습니다.
Cloudflare 장애 (2022년 6월)
6월 Cloudflare의 우발적 장애로 1시간 30분 동안 주요 중단이 발생하여 다음 인기 사이트들이 다운되었습니다:
- Discord
- Shopify
- Fitbit
- Peloton
샌프란시스코 기반 벤더는 계획되지 않은 다운타임이 19개 데이터 센터의 네트워크 구성 변경에서 기인했다고 설명했습니다.
클라우드 장애 계획의 가치를 간과하지 마세요
최근 몇 년간의 클라우드 장애 사례들은 명확한 메시지를 보냅니다: 클라우드가 IT 게임 체인저임에도 불구하고 기술은 완벽하지 않습니다. 최종 사용자와 앱 가용성을 중요하게 생각하는 기업들은 가끔 발생하는 다운타임에 대비해야 하며, 이는 백업과 재해 복구(BDR)를 클라우드 기반 리소스 사용의 필수적인 부분으로 만듭니다.



