최근 자동 음성 인식(ASR) 기술의 획기적인 발전으로 음성이 수많은 기기의 주요 인터페이스로 자리 잡았습니다. IEEE Spectrum은 2017년을 '음성 인식의 해'로 지명했고, ZDNet은 CES에서 음성이 차세대 주요 컴퓨터 인터페이스라고 보도했습니다. 오늘날의 음성 생태계와 이를 구동하는 기술을 개괄합니다.
당신의 기기 중 몇 대가 당신과 대화하나요?
음성 활성화는 이제 보편화되었습니다. 아이폰 7, 갤럭시 S7 등 모든 플래그십 스마트폰에는 상시 켜진 음성 비서가 탑재되어 있으며, 스마트워치, 웨어러블, 히어러블(애플 에어팟, 삼성 기어 아이콘X 등)도 마찬가지입니다. 많은 기기에 기존 UI가 없어 음성이 유일한 상호작용 수단입니다. 고프로 히어로 5 같은 신형 카메라는 핸즈프리 셀카를 위한 음성 명령을 지원하고, 자동차 인포테인먼트 시스템은 안전한 운전을 위해 음성 제어 오디오를 표준으로 채택했습니다.
아마존 에코는 대화형 비서 붐을 일으켰습니다. 아마존의 음성 서비스 알렉사는 농담, 스포츠 점수, 영화 퀴즈 등 수십 가지 내장 스킬과 이스터 에그를 제공합니다. 개발자는 알렉사 스킬 키트(ASK)로 기능을 확장할 수 있습니다. 예를 들어, 한 취미 개발자가 맞춤 스킬을 만들어 아이로봇 룸바를 음성 제어 청소기로 탈바꿈시켰습니다. 알렉사는 음식 주문, 차량 호출, 월풀·GE 등 스마트홈 기기 제어 같은 실용적 서비스도 지원합니다.
아마존이 여전히 시장을 선도하지만 경쟁사들도 격차를 좁히고 있습니다. 페이스북은 모건 프리먼을 자사 AI 비서의 목소리로 고용했는데, 저커버그가 1년간 개발해 '자비스'라 부릅니다. 이 시스템은 음성으로 사용자 식별, 얼굴 인식, 안전한 출입 제어가 가능합니다. 일본에서는 게이트박스가 홀로그램 비서 '아즈마 히카리'를 선보이며 스피커, 프로젝터, 카메라, 모션 센서를 결합해 더 몰입감 있는 경험을 제공합니다.
원거리 음성 수신(파필드)은 어떻게 작동하나요?
배경 음악이 재생 중이거나 방 건너편에서도 음성 명령을 이해하려면 여러 첨단 기술이 필요합니다:
딥러닝
최신 ASR의 핵심입니다. 방대한 데이터셋으로 훈련된 신경망이 음성 및 시각 인식에서 인간 수준의 성능을 달성하거나 넘어섰습니다. 훈련된 모델은 기기 하드웨어에서 실시간으로 실행됩니다.
적응형 빔포밍
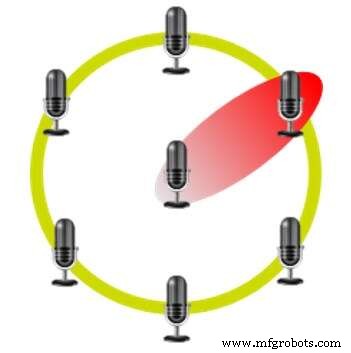
화자의 방향에 초점을 맞춰 신뢰성을 높입니다. 에코 같은 기기는 7개 마이크로 구성된 육각형 어레이를 사용해 신호 도달 시간 차이를 감지하고, 이동하는 화자를 추적하며, 여러 목소리를 분리합니다.
육각형 마이크 어레이를 이용한 빔포밍 (출처: CEVA)
음향 에코 제거
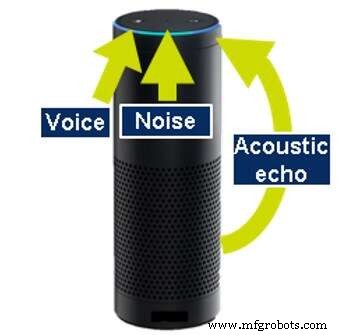
기기 자체에서 나오는 오디오(음악, 음성 응답)를 제거하여 사용자 명령을 계속 들을 수 있게 합니다. 시스템은 출력 데이터를 분석하거나 전용 마이크를 사용해 자신이 생성한 소리를 모델링하고, 이를 입력 신호에서 빼냅니다. 덕분에 음악이 재생 중에도 사용자가 끼어들기('barge-in')가 가능합니다.
음향 에코 제거 (출처: CEVA)
디레버버레이션 같은 추가 에코 감소 기술은 벽 등에서 반사되는 예측 불가능한 반향을 걸러내어 ASR 엔진이 깨끗한 음성 샘플을 받도록 합니다.
현재의 음성 인터페이스는 여전히 진화 중
2017년은 음성 채택의 중요한 이정표지만, 지연 시간, 문맥 인식, 다중 화자 지원, 프라이버시 등 과제가 남아 있습니다. 다음 글에서 이러한 한계를 다룰 예정이니 기대해 주세요.
에란 벨라시(Eran Belaish)는 CEVA의 오디오 및 음성 포트폴리오 제품 마케팅 매니저로, 음성 트리거부터 무선 오디오까지 솔루션을 개발합니다. 음향 기술에 몰두하지 않을 때는 조용한 수중 세계에서 프리다이빙을 즐깁니다.