Python으로 기본 퍼셉트론 신경망 학습시키기: 단계별 가이드
Python으로 기본 퍼셉트론 신경망 학습시키기
이 가이드는 단일층 퍼셉트론 가중치를 자동 학습하는 완전 주석 달린 Python 구현을 안내합니다. 코드는 복사-붙여넣기, 실행, 자체 데이터 적용 가능.
AAC 퍼셉트론 시리즈 탐색
더 깊은 맥락이나 고급 주제 진입 위해 나머지 글 확인:
- 신경망으로 분류 수행: 퍼셉트론이란?
- 단순 퍼셉트론 예제로 데이터 분류하기
- 기본 퍼셉트론 신경망 학습시키기
- 단순 신경망 학습 이해
- 신경망 학습 이론 입문
- 신경망의 학습률 이해
- 다층 퍼셉트론으로 고급 머신러닝
- 시그모이드 활성화 함수: 다층 퍼셉트론에서의 활성화
- 다층 퍼셉트론 신경망 학습시키기
- 다층 퍼셉트론의 학습 공식과 역전파 이해
- Python 구현을 위한 신경망 아키텍처
- Python으로 다층 퍼셉트론 신경망 만들기
- 신경망을 이용한 신호 처리: 신경망 설계에서의 검증
- 신경망용 학습 데이터셋: Python 신경망 학습 및 검증
단일층 퍼셉트론 분류
3D 공간 고전 이진 분류 문제로 시작. 네트워크 아키텍처: 3 입력 노드, 단일 은닉층, 유닛스텝 활성화 함수 쓰는 1 출력 노드.
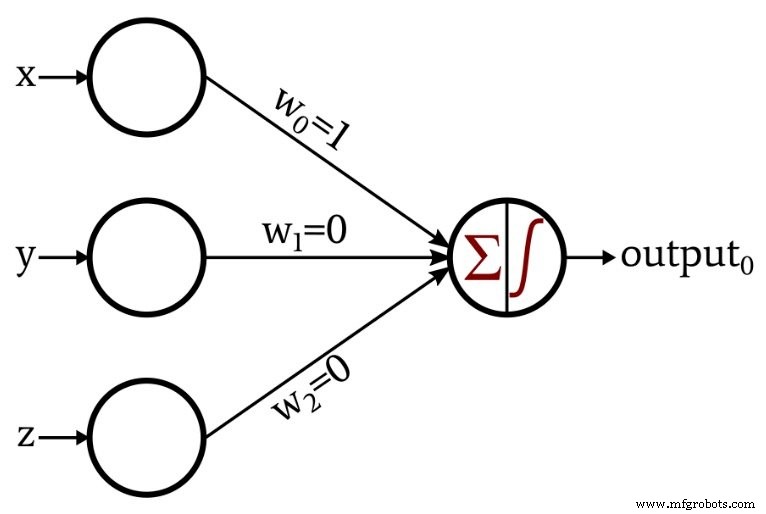
출력 노드 다음 유닛스텝 함수 적용:
\[f(x)=\begin{cases}0 & x < 0\\1 & x \ge 0\end{cases}\]
학습 시연 위해 아키텍처 확장해 단순 학습 루프로 가중치 자동 조정:
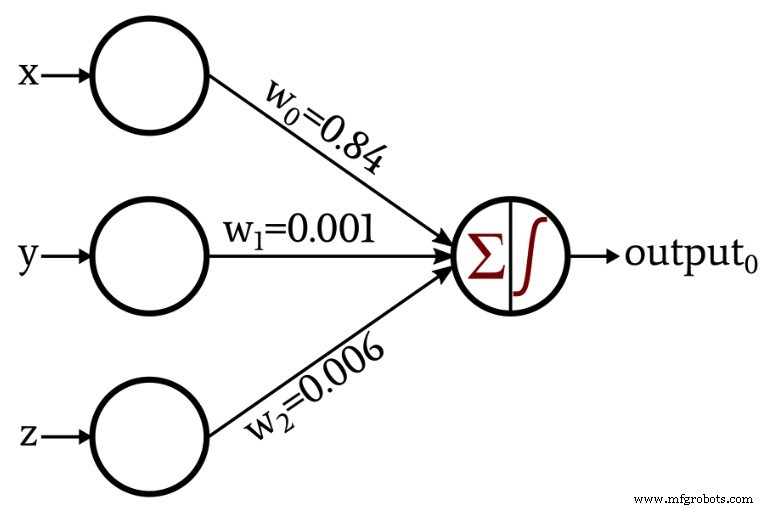
Python 구현
다음 스크립트: 엑셀 파일서 학습 데이터 읽고, 가중치 랜덤 초기화, 퍼셉트론 학습 규칙으로 반복 업데이트.
 import pandas
import numpy as np
# 입력 공간 차원 (x, y, z)
input_dim = 3
# 학습률: 가중치 조정 크기 제어
learning_rate = 0.01
# 랜덤 초기 가중치; 재현성 원하면 고정값 설정
Weights = np.random.rand(input_dim)
# Weights = np.array([0.5, 0.5, 0.5])
# 데이터셋 로드: 각 특성 컬럼과 'output' 컬럼 가진 시트
Training_Data = pandas.read_excel("3D_data.xlsx")
# 예상 출력을 특성 행렬에서 분리
Expected_Output = Training_Data.output
Training_Data = Training_Data.drop(["output"], axis=1)
# 벡터 연산 위해 NumPy 배열 변환
Training_Data = np.asarray(Training_Data)
training_count = len(Training_Data[:, 0])
# 여러 에포크 학습
for epoch in range(5):
  for datum in range(training_count):
    # 입력 가중합
    Output_Sum = np.sum(np.multiply(Training_Data[datum, :], Weights))
    # 유닛스텝 활성화 적용
    Output_Value = 0 if Output_Sum < 0 else 1
    # 예상과 실제 출력 간 오차
    error = Expected_Output[datum] - Output_Value
    # 학습 규칙 따라 각 가중치 업데이트
    for n in range(input_dim):
      Weights[n] += learning_rate * error * Training_Data[datum, n]
print(f"w_0 = {Weights[0]:.3f}")
print(f"w_1 = {Weights[1]:.3f}")
print(f"w_2 = {Weights[2]:.3f}")
핵심 개념 설명
네트워크 구성과 데이터 정리
네트워크 3 입력 노드로 3D 좌표 매칭. 학습률 0.01 표준 시작점; 실험 후 조정 가능. 가중치 대칭 깨기 위해 랜덤 시드, 결정론적 동작 원하면 고정값 설정.
학습 데이터 엑셀 파일서 읽고 입력/예상 출력 분리, NumPy 배열 변환해 효율적 계산.
출력값 계산
각 에포크 모든 학습 샘플 반복. 각 샘플마다 입력 가중합 계산. 유닛스텝 함수로 합 이진 출력 매핑: 합 음수면 0, 아니면 1.
가중치 업데이트
예측 출력이 예상 출력과 다를 때 퍼셉트론 학습 규칙 각 가중치 입력값, 오차, 학습률 비례 조정:
\[w_{new} = w + (\alpha \times \delta \times input)\]
여기서 \(\delta = \text{output}_{expected} - \text{output}_{calculated}\), \(\alpha\)는 학습률.
결론
단일층 퍼셉트론 Python 완전 주석 구현 확인. 코드는 다양한 데이터셋, 학습률, 향후 다중 출력 확장 실험 기초로 탄탄.



