정보는 힘입니다. 대부분의 기업에게 가치 있는 비즈니스 정보가 문서에 갇혀 있습니다. 기업이 관리하는 문서 유형, 크기, 형식의 다양성을 고려할 때, 인사이트를 얻기 위해 문서를 효율적으로 처리하는 것은 어려운 과제입니다.
UiPath는 이 과제를 잘 이해하고 있습니다. 우리의 최신 문서 이해 프레임워크 덕분에 고객은 문서 유형, 형식, 볼륨에 관계없이 광범위한 문서에 대한 데이터 추출과 처리를 쉽게 자동화할 수 있습니다. 이는 귀사의 고유한 니즈에 가장 적합한 프로세스를 사용해 문서 처리에 유연하게 접근할 수 있게 해줍니다.
문서 이해의 이점에 대한 높은 수준의 개요는 백서 Document Understanding으로 운영 효율성 높이고 위험 완화하기를 참조하세요.
이 아티클에서는 다음을 다룹니다:
일반적인 문서 유형과 분류 검토
규칙 기반 및 모델 기반 데이터 추출 방법 검토
각 표준 접근법을 문서 처리에 적용할 때 기업이 직면하는 일반적인 과제 분석
두 문서 처리 접근법을 다중 접근 데이터 추출 방법으로 결합했을 때 기업이 얻을 수 있는 이점 검토
시작해 보겠습니다.
문서 환경
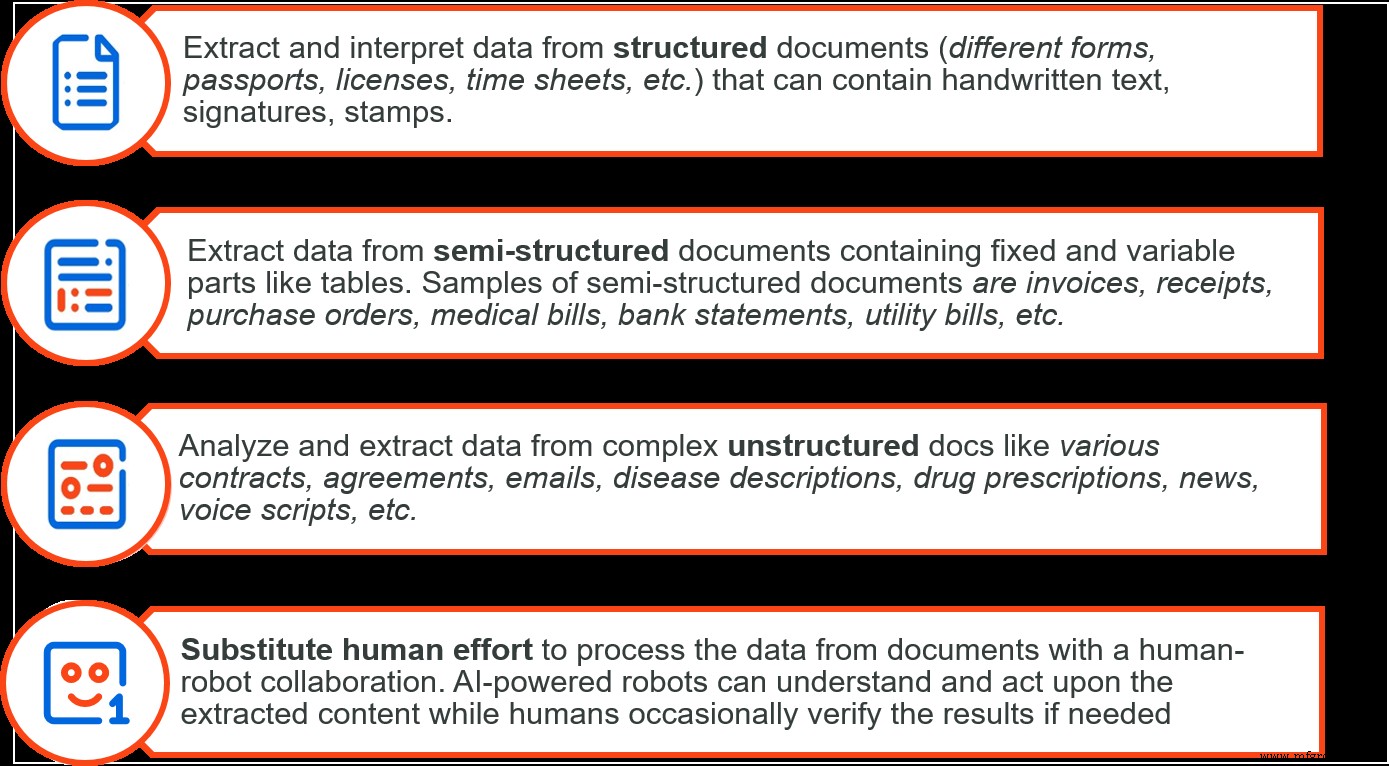
구조와 형식에 따라 문서는 세 가지 유형으로 분류할 수 있습니다.
세금 양식처럼 형식이 고정된 문서들 — 이들은 정형 문서(structured documents)라고 부릅니다.
계약서처럼 표준 구조가 없는 문서들 — 이들은 비정형 문서(unstructured documents)라고 부릅니다.
레이아웃이나 디자인이 다양하지만 유사한 유형의 정보를 포함하는 문서들 — 이들은 반정형 문서(semi-structured documents)라고 부릅니다. 영수증, 송장, 구매 주문서가 이 범주의 일반적인 예입니다.
문서 분류에 따라 두 가지 일반적인 데이터 추출 방법론이 있습니다. 규칙 기반 데이터 추출은 정형 문서를 대상으로 하고, 모델 기반 데이터 추출은 반정형 및 비정형 문서를 처리하는 데 사용됩니다.
규칙 기반 데이터 추출 방법의 이점과 한계
규칙 기반 데이터 추출은 문서에서 데이터를 추출하기 위해 규칙 세트에 의존합니다. 예를 들어 문서 템플릿을 만들고 특정 데이터 위치 기반 규칙을 적용할 수 있습니다. 또는 템플릿을 만들 필요 없이 일부 데이터 세트가 문서에서 얼마나 자주 사용되는지(발생 패턴)나 해당 데이터 변수가 문자 시퀀스에서 일반적으로 어떻게 보이는지(정규 표현식 또는 regex) 기반으로 규칙을 적용할 수 있습니다.
전자는 템플릿화할 수 있는 양식을 다룰 때 유용하고, 후자는 그런 규칙을 만들 수 있고 쉬울 때 사용됩니다. 규칙 기반 방법은 설정하고 이해하기 쉽고 문서 처리에서 매우 효율적으로 작동합니다. 하지만 정형 문서와 일부 단순한 반정형 문서 경우로 제한됩니다.
따라서 규칙 기반 데이터 추출 기법은 많은 맥락에서 유용하지만 명백한 적용 한계가 있습니다. 템플릿 기반 추출은 고정된 문서 레이아웃과 밀접하게 연결되어 있어 레이아웃 변경 시 규칙이 깨지고 재구성이 필요합니다.
마찬가지로 정규식 기반 기법은 상황이 복잡해질수록 구현, 문제 해결이 어렵고 번거로워질 수 있습니다. 그러나 규칙 기반 추출 솔루션의 대안적 접근법인 모델 기반 접근법이 있습니다.
모델 기반 데이터 추출 방법의 이점과 한계
모델 기반 데이터 추출 방법론은 머신러닝(ML)에 기반합니다. 이 방법들은 다양한 문서 세트로부터 학습할 수 있는 능력 덕분에 강력합니다. 우리는 자연어 처리(NLP)와 통계적 학습 같은 정교한 기법을 사용해 이러한 방법들을 구현합니다.
UiPath 검증 스테이션(Validation Station)은 사용자에게 인간 개입(Human-in-the-loop) 기능을 제공해 모델이 실시간으로 학습하고 데이터 변경에 적응할 수 있게 합니다. 인공지능(AI) 기반 기술은 일반적으로 반정형 및 비정형 문서에서 데이터 추출에 사용됩니다. 예를 들어 영수증과 송장 처리 같은 시나리오를 다루기 위해 문서 이해 프레임워크에서 사용할 ML 모델들을 만들었습니다.
더 읽기: AI로 송장 및 영수증 처리 자동화하기
모델 기반 추출 기법을 사용할 때의 과제는 ML 모델을 생성하고 구현하는 데 시간과 전문성이 필요할 수 있다는 점입니다. 하지만 많은 시나리오에서 모델 기반 기법은 다양한 문서 구조와 포함 사항을 학습하고 적응하는 능력에서 우월합니다.
다중 접근 데이터 추출 수용
모든 문서 처리 니즈를 해결할 수 있는 은탄환은 없습니다. 규칙 기반과 모델 기반 접근법 모두 강력한 도구지만, 기업이 관리하는 문서 범위를 최적으로 처리하는 능력에는 한계가 있습니다.
일부 정형 문서는 규칙 기반 방법론 이상의 것을 필요로 할 수 있습니다. 일부 데이터는 규칙이나 템플릿으로는 추출할 수 없기 때문입니다. 마찬가지로 순수하게 모델 기반 방법만으로는 모든 비정형 및 반정형 문서에 작동하지 않습니다.
우리는 사용자가 단일 문서에서 정보를 추출하기 위해 다양한 접근법을 쉽게 결합할 수 있기를 바랍니다. 그래서 우리의 문서 이해 프레임워크는 개별 접근법이 부과하는 한계를 극복할 수 있는 힘을 주도록 설계되었습니다. 복잡한 문서를 다루고 데이터 추출 과정에서 최고 수준의 정확성을 달성하고자 할 때 다중 접근 데이터 추출 사용을 강력히 권장합니다.
빠르고 정확한 다중 접근 데이터 추출
우리의 유연한 프레임워크를 사용하면 UiPath Studio에서 워크플로에 여러 데이터 추출 기법을 단순히 드롭하는 것만으로 문서 처리 접근법을 조합할 수 있습니다.
데이터 처리를 위한 추출기를 쉽게 구성하고, 추출 실행 우선순위를 설정하고, 특정 추출기 결과가 유효한 것으로 받아들여지기 위한 임계값을 설정할 수 있습니다. 이렇게 하면 가변적인 문서 구조나 데이터 추출을 위한 복잡한 규칙도 더 이상 과제가 되지 않습니다. 동시에 엔드투엔드 자동화 내에서 최신 AI 기술로 더 빠르고 훨씬 더 정확한 문서 처리를 얻을 수 있습니다.
관심 있으신가요?
효율적이고 정확한 문서 추출 및 처리 기능은 필수적입니다. 다중 접근 데이터 추출에 중점을 두어 UiPath 고객에게 문서 처리와 분석을 가능한 한 쉽게 만들고자 합니다.
현재 확장된 Document Understanding 기능과 기능성은 이전 파일럿에 참여한 사용자를 위해 SaaS(Software-as-a-Service) 베타 버전으로 제공됩니다. 이러한 기능과 기타 고급 Document Understanding 도구는 곧 제공될 예정입니다. 그동안 UiPath 엔터프라이즈 체험판에 등록해 UiPath Document Understanding 솔루션에 접근해 보시길 권장합니다.