이 글에서는 멀티코어 프로세서의 진화, 증가하는 보급, 동반되는 설계·성능·디버깅 고려사항을 다룬다.
시스템 성능
임베디드 시스템 성능 향상은 정교한 컴파일러 최적화, 효율적 하드웨어 아키텍처, 점점 더 여러 코어 간 병렬 실행으로 달성된다. 영리한 컴파일러 알고리즘이 단일 스레드 코드에서 추가 속도를 짜낼 수 있지만, 클록 주파수가 몇 년마다 2배씩 증가한다는 오랜 가정은 더 이상 성립하지 않는다. 현대 성능 한계는 저개 Gigahertz 범위에 머물러 있어 병렬처리가 확장의 가장 실행 가능한 경로다.
병렬성
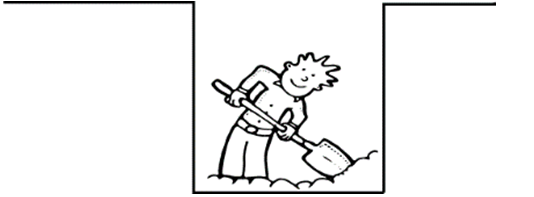
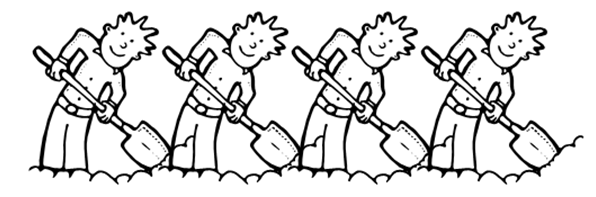
모든 작업이 병렬화에 동등하게 적합한 것은 아니다. 한 사람이 깊은 구멍을 파야 하므로 그 구멍에 더 많은 인부를 투입해도 작업이 빨라지지 않는다. 오히려 진도를 방해할 수 있다. 반면 도랑 파기는 고도로 병렬적이다: 여러 인부가 나란히 파며 각자 전체 작업의 일부를 담당한다.
위 그림은 MIMD(Multiple Instruction, Multiple Data)를 묘사한다. 각 작업자(코어)가 서로 다른 연산을 수행할 수 있다. 4개 독립 작업자로 1개 코어가 1분 걸릴 작업을 약 15초에 완료할 수 있다.
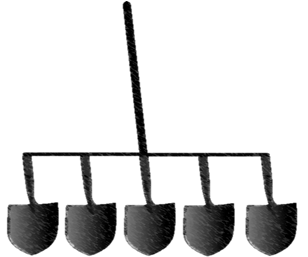
반면 SIMD(Single Instruction, Multiple Data)는 동일한 명령을 여러 데이터 요소에 동시에 실행한다. 이미지 필터링이나 벡터 연산처럼 규칙적 반복 연산 워크로드에 이상적이지만 범용 컴퓨팅엔 유연성이 부족하다.
이러한 고려사항이 멀티코어 프로세서 부상의 기반이다: 단일 다이에 여러 전체 CPU 서브시스템을 임베딩함으로써 설계자는 소프트웨어가 병렬성을 활용하도록 작성되면 성능을 선형적으로 확장할 수 있다.
멀티코어 프로세싱 유형
프로세서는 다양한 방식으로 코어를 결합할 수 있으며, 이는 워크로드 분배와 코어 간 통신에 영향을 준다.
동종 멀티코어(Homogeneous Multicore)
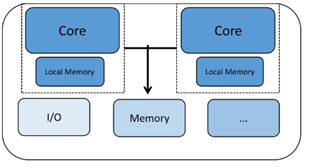
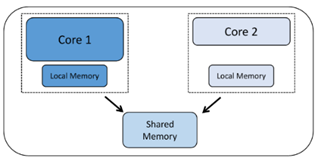
두 개 이상 동일한 코어, 각각 자체 레지스터, 기능 유닛, 종종 전용 L1 캐시 보유. 코어 통신은 공유 메모리나 메일박스 메커니즘으로 이뤄진다. 모든 코어가 동일 타입이므로 동일한 바이너리가 어느 코어에서든 실행 가능하다.
이종 멀티코어(Heterogeneous Multicore)
서로 다른 코어 타입 혼합, 각자 특정 워크로드에 최적화. 예: 블루투스 컨트롤러가 한 코어를 프로토콜 처리에, 다른 코어를 상위 애플리케이션 로직에 전담. 모바일 SoC와 산업용 컨트롤러에서 흔하다.
코어 분배 패턴이 멀티코어 설계를 추가로 구분한다:
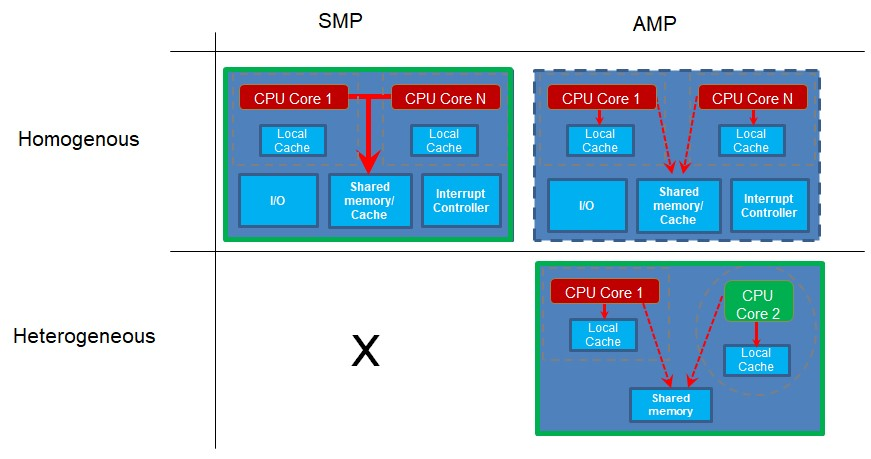
대칭 멀티프로세싱(SMP)
여러 동일한 코어가 동일한 바이너리 실행, 실시간 OS(RTOS)가 조정. 스케줄러가 코어 간 작업 분배, 바이너리는 단일 코어 타입용으로 컴파일.
비대칭 멀티프로세싱(AMP)
각 코어가 전용 바이너리 실행. 코어는 동종 또는 이종일 수 있음. 통신은 선택적이며 공유 메모리나 메시징 프리미티브로 처리.
SMP가 단일 바이너리를 요구하므로 동종 코어를 강제한다. AMP는 동종·이종 시스템 모두에 구현 가능해 서로 다른 전문 워크로드가 필요한 애플리케이션에 이상적이다.
멀티코어 사용 이유
무어의 법칙이 둔화되면서 다이에 더 많은 코어를 집적하는 것이 고성능을 위한 가장 효과적 경로다. 클록 속도가 저개 GHz 범위에서 정체된 반면 트랜지스터 밀도는 계속 증가해 더 풍부한 인터커넥트와 더 큰 온칩 캐시를 가능하게 한다. 멀티코어 설계는 이 집적도의 잠재력을 완전히 해방한다.
이종 AMP는 실시간·처리량 중심 워크로드에 특히 강력하다. 시간 중요 기능을 전용 코어에 격리함으로써 설계자는 전체 시스템 처리량 저하 없이 엄격한 지연 보장을 충족할 수 있다. 이 분리 덕분에 실시간 구성요소를 애플리케이션 로직과 독립적으로 검증할 수 있어 인증도 단순화된다.
멀티코어 사용 과제
멀티코어 아키텍처 채택은 수많은 소프트웨어·시스템 과제를 도입한다:
태스크 그래뉼러리(Task Granularity) – 단일체 애플리케이션은 여러 코어를 효율적으로 활용 못함. 개발자는 독립적 태스크로 리팩토링해 동시 실행 가능하게 해야 함. 나쁜 스레드 설계는 저활용이나 경합 유발.
동기화 병목(Synchronization Bottlenecks) – 공유 데이터 구조와 I/O 디바이스는 락(뮤텍스, 스핀락, 읽기-쓰기 락 등) 필요. 과도한 락이나 높은 경합은 작업을 직렬화해 병렬 이득 무효화.
로드 불균형(Load Imbalance) – 한 코어가 일찍 끝나고 다른 코어가 지연되면 유휴 코어는 낭비된 컴퓨트 사이클. 큰 작업을 작고 균등한 청크로 분해 필수.
실시간 제약(Real-time Constraints) – SMP 시스템에서 RTOS 스케줄러는 지연과 처리량 균형 맞춰야. 데이터 파티셔닝(각 스레드가 데이터 블록 처리)과 기능 파티셔닝(각 스레드가 파이프라인 구분 단계 수행) 선택은 워크로드 프로필에 의존.
멀티코어 환경 디버깅
효과적 디버깅은 모든 코어에 대한 포괄적 가시성에 달려 있다:
조정된 제어(Coordinated Control) – 디버거는 여러 코어에서 동시/독립적 정지, 스텝, 브레이크포인트 설정 허용해야 함.
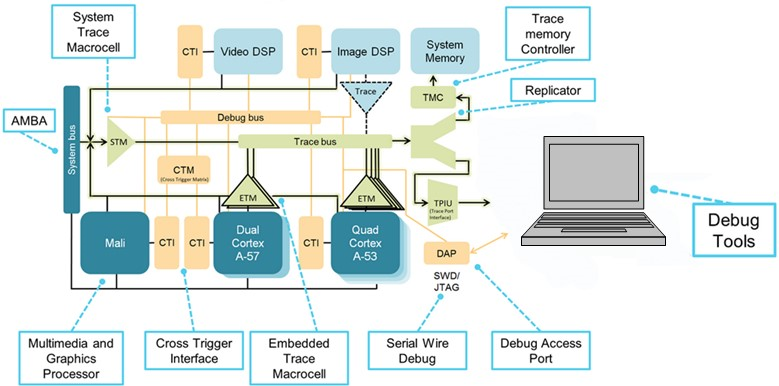
멀티코어 트레이스(Multicore Trace) – 여러 코어에서 동시 트레이스 데이터 캡처는 고대역폭 전송(예: 코어사이트 CoreSight SWD·TPIU 포트)과 지능적 필터링으로 데이터 과부하 방지 필요.
(출처: IAR Systems, 다이어그램 제공: Arm Ltd.)
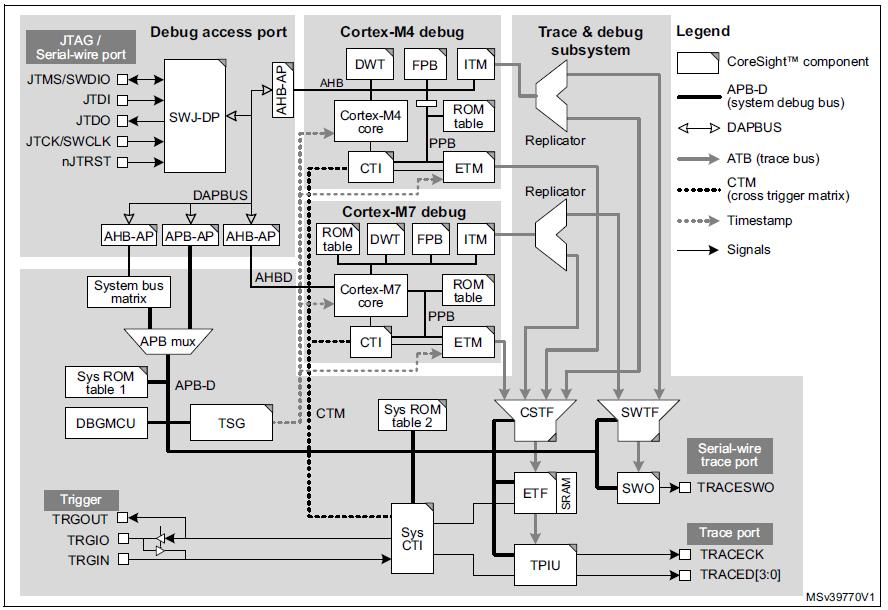
Arm 코어사이트 디버그 아키텍처는 교차 트리거 인터페이스(CTI)와 교차 트리거 매트릭스(CTM)를 통합해 디버거가 다른 코어 이벤트에 반응해 아무 코어에서나 정지나 트리거 동작을 수행할 수 있게 한다. 이 능력은 레이스 컨디션과 데드락 진단에 필수적이다.
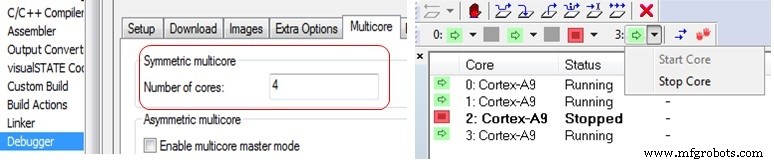
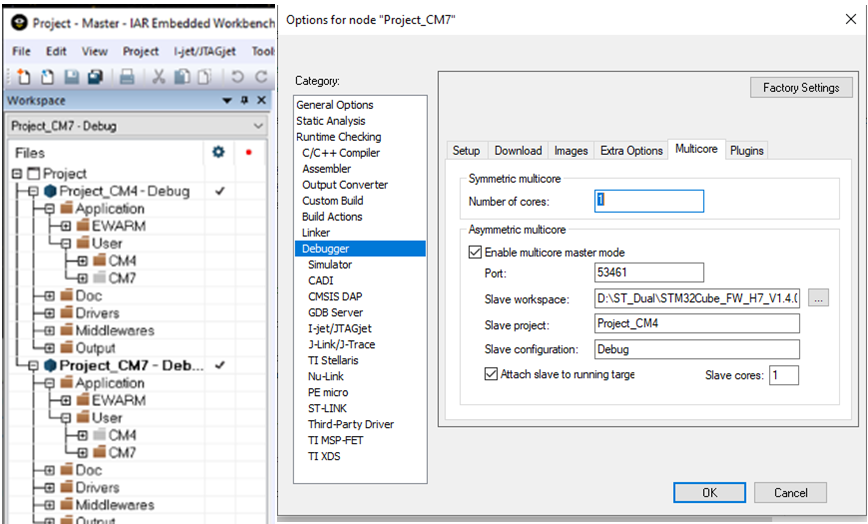
IAR 임베디드 워크벤치 C-SPY 디버거는 SMP와 AMP 구성을 모두 지원. SMP는 사용자가 코어 수 지정하면 디버거가 각 코어에 자동 연결. AMP 지원은 코어가 별도 바이너리 실행 시 두 IDE 인스턴스(마스터와 노드) 필요.
우측 뷰에 4코어 Cortex-A9 SMP 클러스터 표시: 코어 2가 정지된 동안 나머지 코어 계속 실행.
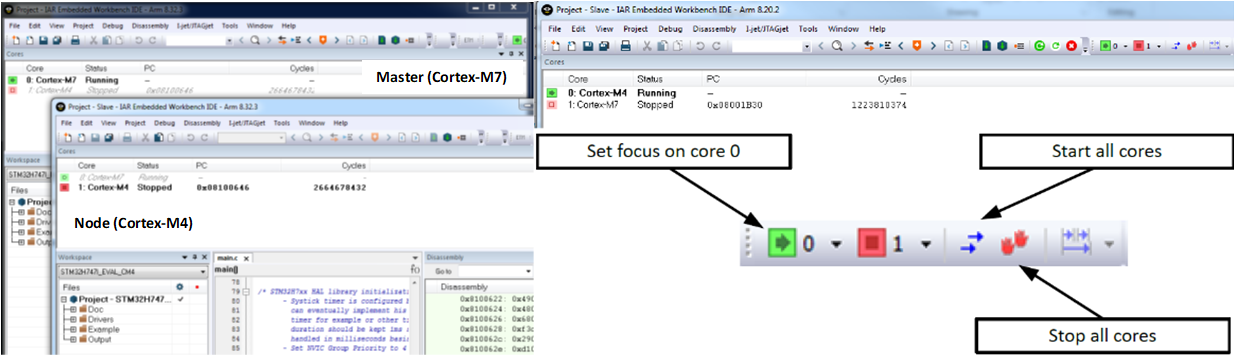
ST STM32H745/755(Cortex-M7 + Cortex-M4) 같은 이종 시스템에서는 디버거가 각 코어별 별도 IDE 창을 띄운다. 각 창은 해당 코어 상태와 선택적으로 다른 코어 상태 표시해 개발자가 실시간 코어 간 상호작용 관찰 가능.
두 CTI(시스템 레벨, Cortex-M4, Cortex-M7)가 CTM으로 연결돼 디버거가 브레이크포인트와 트레이스 트리거에 세밀한 제어 제공.
(출처: IAR Systems, 다이어그램 제공: ST마이크로일렉트로닉스 M0399 레퍼런스 매뉴얼)
일반적 애플리케이션은 공유 메모리 인터페이스와 경량 RTOS(예: FreeRTOS)로 코어 간 메시지 교환. 각 코어 관점에서 통신은 단순 태스크 메시징으로 나타나 하부 코어 간 메커니즘을 추상화.
워크스페이스 익스플로러에 두 프로젝트(Cortex-M7, Cortex-M4) 표시, 사용자가 포커스 전환 가능. 마스터 프로젝트가 두 번째 IDE 인스턴스 자동 실행해 AMP 디버깅 단순화.
요약
멀티코어 아키텍처는 무어의 법칙 둔화 시 필요한 성능을 제공하지만 규율 있는 소프트웨어 설계와 정교한 디버깅 툴을 요구한다. 디버그 환경 구성 후 개발자는 멀티코어 디버깅이 모노코어 시스템만 다뤄본 이들이 보고하는 과제 대비 놀랍도록 단순함을 발견한다.
현대 하드웨어와 통합 소프트웨어 툴링으로 멀티코어 성능을 활용하면서 신뢰성과 추적성을 유지하는 것이 이제 실용적이다.
참고: 그림 이미지는 별도 표기 없으면 IAR Systems 제공.
아론 바우흐(Aaron Bauch)는 IAR Systems 시니어 필드 애플리케이션 엔지니어로 미국 동부와 캐나다 고객 지원. 인텔, 아날로그 디바이시스, 디지털 이큅먼트 코퍼레이션 등 기업과 임베디드 시스템·소프트웨어 작업. 의료 계측, 내비게이션, 뱅킹 시스템 등 광범위한 애플리케이션 설계. 서던 NH 대학교 교수로 임베디드 시스템 설계 강의도 담당. 쿠퍼 유니온 전기공학 학사, 컬럼비아 대학교 전기공학 석사 보유.




 아론 바우흐(Aaron Bauch)는 IAR Systems 시니어 필드 애플리케이션 엔지니어로 미국 동부와 캐나다 고객 지원. 인텔, 아날로그 디바이시스, 디지털 이큅먼트 코퍼레이션 등 기업과 임베디드 시스템·소프트웨어 작업. 의료 계측, 내비게이션, 뱅킹 시스템 등 광범위한 애플리케이션 설계. 서던 NH 대학교 교수로 임베디드 시스템 설계 강의도 담당. 쿠퍼 유니온 전기공학 학사, 컬럼비아 대학교 전기공학 석사 보유.