BrainChip, 에지 AI용 Akida 뉴로모픽 개발 키트 출시
선도적인 뉴로모픽 컴퓨팅 IP 제공업체 BrainChip이 최근 Linley Fall Processor Conference에서 Akida 뉴로모픽 SoC를 탑재한 두 가지 새로운 개발 키트를 발표했습니다. 키트는 x86 Shuttle PC 포맷과 Arm 기반 Raspberry Pi 설계로 제공되어, 개발자들에게 스파이킹 신경망(SNN) 애플리케이션 구축과 테스트를 위한 즉시 사용 가능한 플랫폼을 제공합니다. Akida 실리콘은 커스텀 설계에 통합하기 위해 별도로도 제공됩니다.
Akida의 뉴로모픽 아키텍처
Akida의 뉴로모픽 아키텍처는 뇌의 이벤트 주도 프로세싱을 모방하여 초저전력 AI를 제공합니다. 기존 딥러닝 모델과 달리 SNN은 공간적 패턴과 시간적 시퀀스를 모두 인코딩하는 이산적 스파이크를 통해 정보를 전송합니다. 이 이벤트 도메인은 센서 스트림에서 실시간, 전력 의식적 추론을 요구하는 에지 디바이스에 이상적입니다.
네이티브 SNN 워크로드 외에도 BrainChip의 신경망 처리 유닛(NPU)은 MetaTF 소프트웨어 흐름으로 변환한 후 컨볼루션 신경망(CNN)을 실행할 수 있습니다. 이 변환은 CNN 특징 추출을 보존하면서 스파이크 타이밍 의존적 가소성을 통한 온칩 학습을 가능하게 하여 클라우드 기반 재학습의 필요성을 제거합니다.
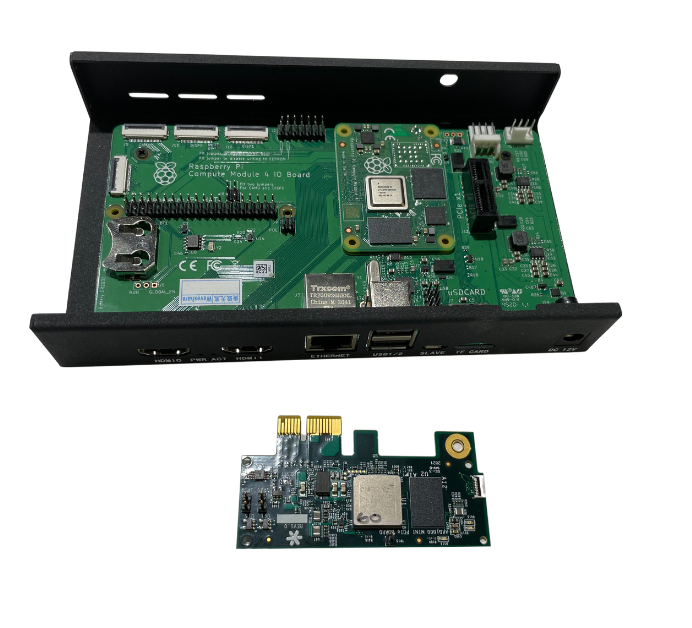
BrainChip의 개발 보드는 x86 Shuttle PC 또는 Raspberry Pi용으로 제공됨. (출처: BrainChip)
"Akida는 내일의 뉴로모픽 기술에 대비되어 있지만, 이미 오늘날의 에지 AI 과제를 해결합니다."라고 BrainChip 공동 창업자이자 최고 개발 책임자인 Anil Mankar가 EE Times에 말했습니다. "우리의 런타임 소프트웨어는 SNN과 이벤트 도메인에 대한 학습 곡선을 제거하여, TensorFlow나 Keras에 익숙한 개발자들이 모델을 포팅하고 우리 하드웨어에서 직접 전력과 정확도를 평가할 수 있게 합니다."
Mankar는 CNN이 대규모 데이터셋에서 특징 추출에 뛰어나다고 설명했습니다. 최종 분류 레이어를 제외한 CNN 레이어를 이벤트 기반 연산으로 변환함으로써 Akida는 이 능력을 유지하면서 스파이크 타이밍 학습을 추가합니다. 네이티브 SNN은 1비트 정밀도를 사용할 수 있는 반면, 변환된 CNN은 일반적으로 1, 2, 4비트 스파이크를 사용합니다. BrainChip의 양자화 도구는 설계자가 레이어당 적절한 비트 폭을 선택하도록 돕습니다. 예를 들어, 4비트로 양자화된 MobileNet V1 모델은 10클래스 분류 작업에서 93.1% 정확도를 달성했습니다.
이벤트 도메인으로의 변환은 희소성 덕분에 상당한 전력 절감도 가져옵니다. 이벤트 도메인에서는 0이 아닌 활성화 값만 스파이크를 생성하고, NPU는 오직 그 이벤트만 처리합니다. 일반적인 CNN에서 ReLU 후 활성화의 약 절반이 0이므로, 이벤트 기반 구현은 MAC 연산 수를 극적으로 줄여 전력 소비를 낮춥니다.
컨볼루션, 포인트와이즈 컨볼루션, 뎁스와이즈 컨볼루션, 맥스 풀링, 글로벌 평균 풀링 등의 기능이 모두 이벤트 도메인으로 변환 가능합니다. 다음 다이어그램은 객체 분류 작업에 대한 MAC 연산 감소를 보여줍니다: 진한 파랑은 기존 CNN, 연한 파랑은 이벤트 도메인 Akida 구현, 녹색은 추가적인 활동 정규화입니다.
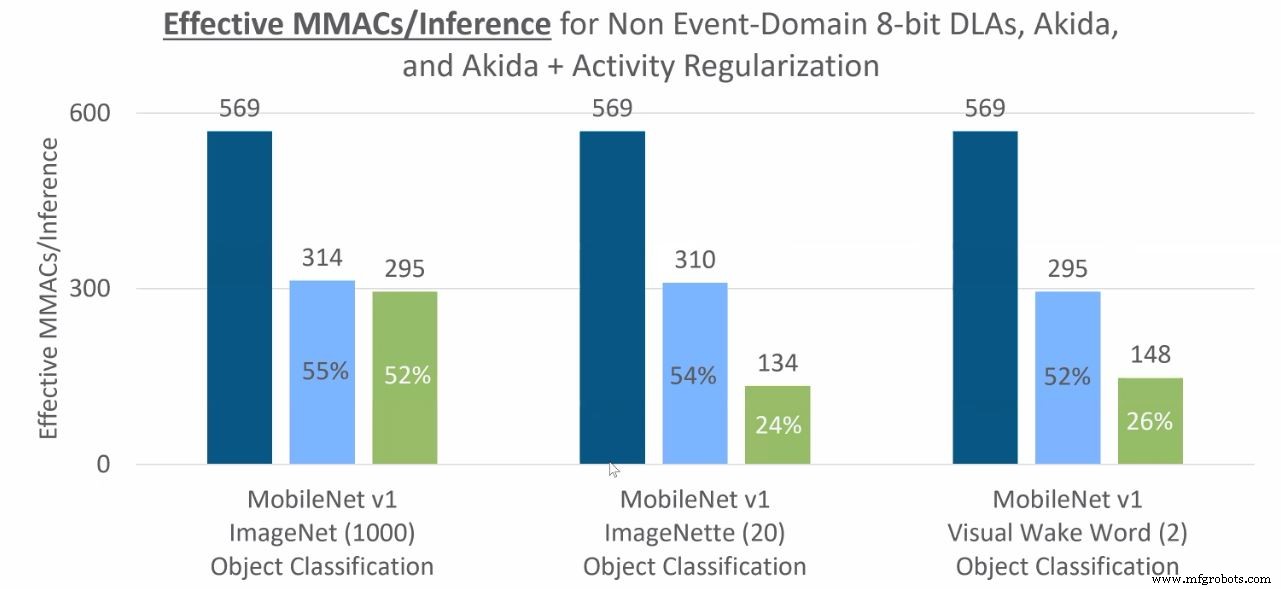
객체 분류 추론에 필요한 MAC 연산 (진한 파랑: 비이벤트 도메인 CNN, 연한 파랑: 이벤트 도메인/Akida, 녹색: 추가 활동 정규화된 이벤트 도메인). (출처: BrainChip)
실제 벤치마크에서, 4비트 양자화 후 Akida 보드에서 실행된 키워드 스포팅 모델은 추론당 단 37µJ를 소비했습니다(와트당 초당 27,336회 추론에 해당). 이 모델은 5MHz의 낮은 클럭에서 동작하며 91.3% 정확도를 달성했습니다.
센서 불가지론(Sensor Agnostic)
BrainChip의 NPU IP와 Akida 칩은 네트워크 불가지론적이며 다양한 센서를 지원합니다. 이미지, 오디오, 후각, 미각, 촉각 데이터 중 무엇을 처리하든 동일한 하드웨어가 CNN(변환 경유)과 네이티브 SNN 모두를 처리할 수 있습니다.
각 NPU 노드는 파라미터, 활성화, 이벤트 버퍼용 100kB 로컬 SRAM을 포함하며, 최대 4개 노드를 메쉬 네트워크로 클러스터링할 수 있습니다. 여러 노드를 아우르는 네트워크는 CPU 개입 없이 레이어 간 직접 통신하며, 특정 비CNN 워크로드는 여전히 CPU 지원이 필요합니다. IP는 20개 노드까지 확장 가능하여 더 큰 모델을 더 작은 하드웨어에서 여러 패스로 실행할 수 있습니다.
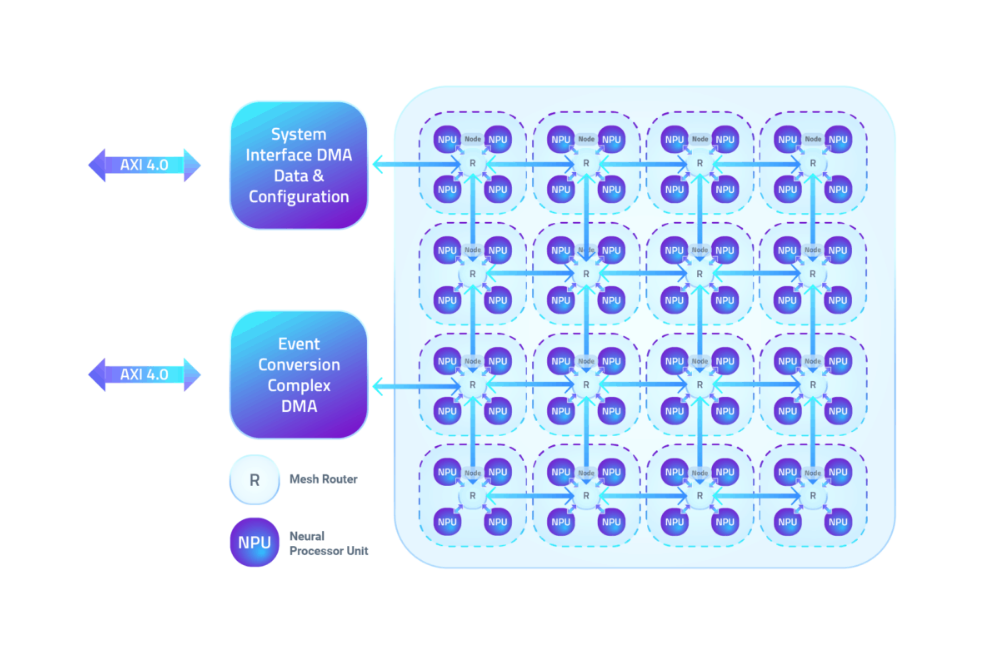
4개 BrainChip NPU 노드가 메쉬 네트워크로 연결됨. (출처: BrainChip)
데모 비디오에서는 Akida가 차량 실내에서 작동하는 모습을 보여주었습니다: 한 칩이 동시에 운전자를 감지하고, 운전자 얼굴을 인식하며, 음성을 식별했습니다. 키워드 스포팅은 600µW, 얼굴 인식은 22mW, 시각적 웨이크워드 추론은 6~8mW만 소모하여 자동차 에지 AI에 대한 칩의 적합성을 입증했습니다.
BrainChip의 전세계 영업 VP인 Rob Telson은 Akida의 28nm TSMC 공정이 강력한 베이스라인을 제공하며, IP 고객은 더 미세한 노드로 이동하여 더 높은 전력 효율을 달성할 수 있다고 언급했습니다. 또한 온칩 학습을 통한 얼굴 인식도 강조했습니다: 최종 레이어에 충분한 뉴런이 있으면 시스템이 10개 얼굴 인식에서 원샷 학습으로 50개 이상으로 확장할 수 있어 클라우드 의존성을 제거합니다.
얼리 액세스 고객
BrainChip은 캘리포니아 알리소 비에호 본사와 프랑스 툴루즈, 인도 하이데라바드, 호주 퍼스의 설계 사무소에서 55명의 직원을 고용하고 있습니다. 회사는 14개의 특허를 보유하고 있으며 호주 증권거래소에 상장되어 있고 미국 OTC 시장에도 등록되어 있습니다.
얼리 액세스 고객에는 NASA, 자동차, 군사, 항공우주, 의료(예: 후각 기반 COVID-19 감지), 가전 기업이 포함됩니다. Renesas는 향후 IoT 배포에서 센서 데이터 분석을 목표로 하는 마이크로컨트롤러 유닛에 통합하기 위해 2노드 Akida NPU IP를 라이선스했습니다.
Akida IP와 실리콘은 현재 이용 가능합니다.
>> 이 기사는 자매 사이트인 EE Times에 원래 게재되었습니다.
관련 콘텐츠:
- 스타트업, 1000개 RISC-V 코어를 AI 가속기 칩에 집적
- 저전력 에지 디바이스 타겟 AI 칩
- AI 지원 SoC, 다중 비디오 스트림 처리
- CPU 기능과 확장으로 AI SoC에 보안 구축
- 마이크로컨트롤러 아키텍처, AI를 위해 진화
더 많은 Embedded 콘텐츠를 위해 Embedded 주간 이메일 뉴스레터를 구독하세요.



