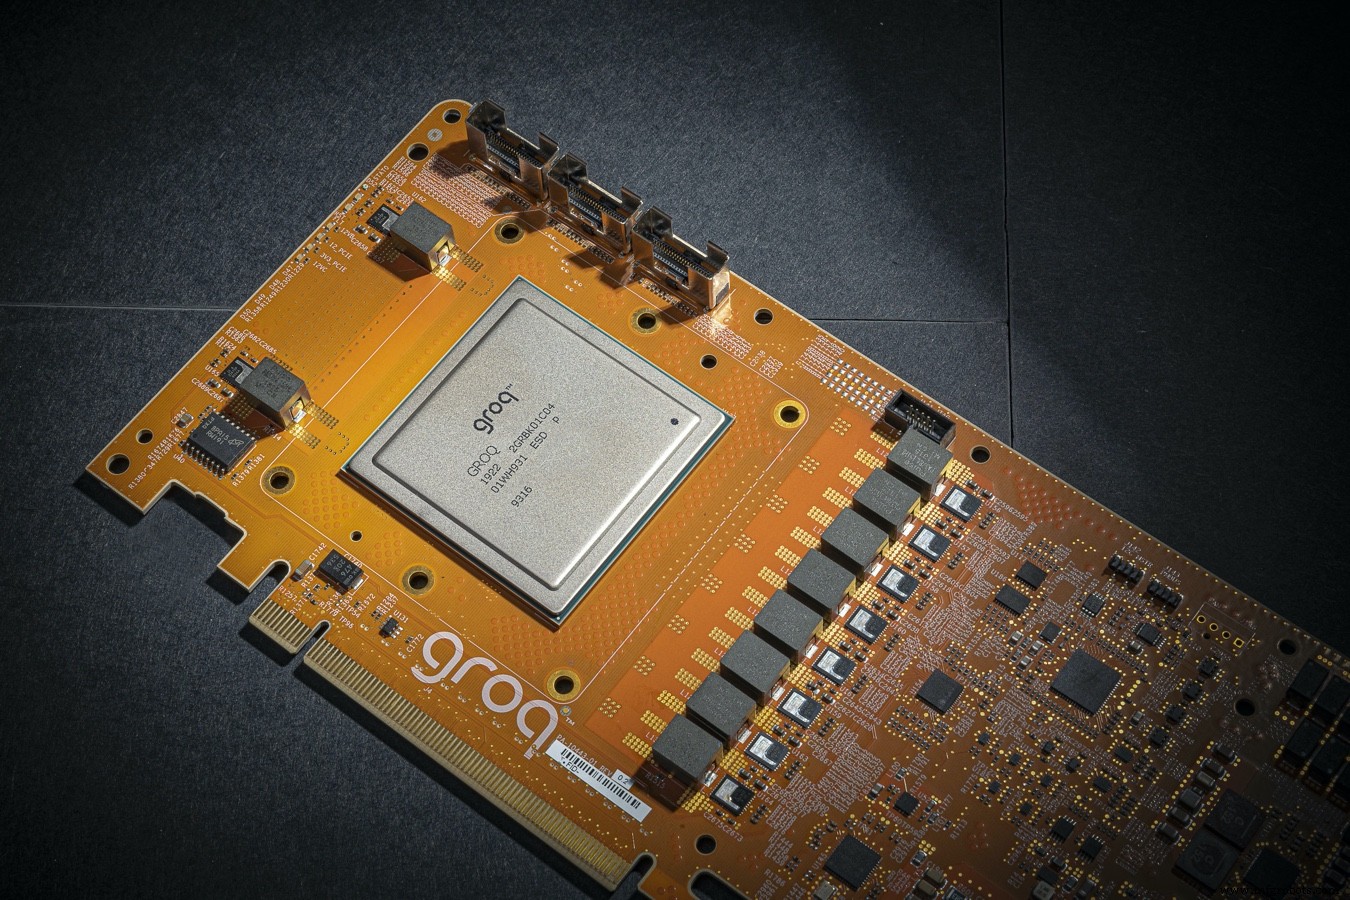
Groq의 텐서 스트리밍 프로세서(TSP) 실리콘이 클라우드에 추가되어 고객이 온디맨드로 AI 워크로드를 가속화할 수 있게 됐다. Nimbix가 이제 선택된 고객들에게 독점적으로 TSP 기반 머신러닝 가속을 제공한다.
데이터센터 AI 실리콘 경쟁 구도
데이터센터 AI 실리콘 경쟁 영역에서 Groq는 Graphcore와 함께 클라우드 서비스에 통합된 상용 가속기를 보유한 유일한 두 스타트업이다. Graphcore의 칩은 이미 Microsoft Azure를 통해 제공된다.
"Groq의 단순화된 처리 아키텍처는 독특하며, 컴퓨팅 집약적 워크로드에 전례 없는 결정론적 성능을 제공하고, 우리 클라우드 기반 AI 및 딥러닝 플랫폼에 흥미로운 추가 요소다"라고 Nimbix CEO Steve Hebert는 말했다.
Groq는 클라우드에서 하드웨어를 제공하는 두 번째 AI 가속기 스타트업이다 (이미지: Groq)
성능 지표
지난 가을 출시된 Groq의 TSP 칩은 놀라운 1,000 TOPS(1 페타 연산/초)를 제공한다. 최근 벤치마크에서 칩은 초당 21,700 ResNet-50 v2 추론을 달성해 현대 GPU 기반 시스템 속도의 2배 이상을 기록하며, 가장 빠른 상용 신경망 프로세서 중 하나로 자리매김했다.
"이 ResNet-50 결과는 Groq의 독특한 아키텍처와 머신러닝 가속 접근법이 경쟁사보다 실질적으로 더 빠른 추론 성능을 제공함을 검증한다"고 Groq 공동창업자 겸 CEO Jonathan Ross는 말했다. "시뮬레이션이나 하드웨어 에뮬레이션이 아닌 업계 표준 벤치마크 기반의 이러한 실제 검증 포인트는 Groq 기술로 가능해진 머신러닝과 AI 애플리케이션의 측정 가능한 성능 이득을 확인시킨다."
아키텍처 이점
Groq의 설계는 CPU와 GPU에서 전형적인 동기화 오버헤드 없이 딥러닝 가속에 필요한 대규모 병렬성을 달성한다. 제어 로직을 컴파일러로 오프로드하는 것(Groq의 소프트웨어 주도 전략의 특징)으로 컴파일 타임에 정량화할 수 있는 완전 결정론적, 예측 가능한 성능을 제공한다.
두드러진 이점은 Groq의 성능 이득이 배치(batch)에 의존하지 않는다는 점이다. 이는 여러 샘플을 동시에 처리해 처리량을 높이는 일반적인 데이터센터 전술이다. TSP 칩은 batch=1에서도 피크 성능에 도달해 실시간 추론 스트림에 이상적이다. 큰 배치 크기에서 GPU 대비 2.5배 레이턴시 이점이지만, batch=1에서는 17배로 치솟는다.