FPGA로 딥러닝 가속화: 속도, 유연성, 에너지 효율
FPGA로 딥러닝 가속화: 속도, 유연성, 에너지 효율
최근 실리콘 밸리에서 열린 2018 Xilinx Development Forum에 참석해 Mipsology라는 스타트업을 발견했습니다. 이 회사는 신경망을 필드 프로그래머블 게이트 어레이(FPGA)에 배포하는 AI 관련 과제를 해결했다고 주장합니다. 대담한 비전으로 설립된 Mipsology는 FPGA가 기존 배포 제약 없이 어떤 신경망이든 최고 성능으로 가속화할 수 있음을 시연합니다.
Xilinx의 새로운 Alveo 보드를 사용해 Mipsology는 ResNet-50, Inception-V3, VGG-19 등 인기 네트워크 제품군에서 초당 20,000장 이상의 이미지를 달성했습니다.
신경망과 딥러닝이란?
인간 뇌의 뉴런 그물에서 영감받은 신경망은 딥러닝(DL)의 중추를 이룹니다. DL은 대량의 데이터에 네트워크를 노출시켜 자율적으로 작업을 수행하도록 학습하는 수학적 프레임워크입니다. 신경망 훈련 과정(수백만 레이블 샘플 제시)에 이어 추론이 오며, 여기서 훈련된 모델이 새 데이터에 대한 결과를 예측합니다.
예를 들어 음성 인식 네트워크는 수천 개 음성 녹음으로 훈련된 후 실시간으로 음성을 전사하는 데 배포될 수 있습니다.
추론이 극한 성능을 요구하는 이유
추론은 초당 수십억에서 수조 회의 덧셈과 곱셈을 요구합니다. 훈련은 한 번만 발생하는 반면 훨씬 더 많습니다. 결과적으로 추론은 프로덕션 AI 시스템의 계산 수요 주요 동인입니다.
딥러닝 추론을 위한 네 가지 하드웨어 옵션
엔지니어들은 전통적으로 네 가지 프로세서 범주에 의존해 왔습니다. 전력 소모 많고 유연성 낮은 순서로: CPU → GPU → FPGA → ASIC. 아래 표가 주요 차이를 요약합니다.
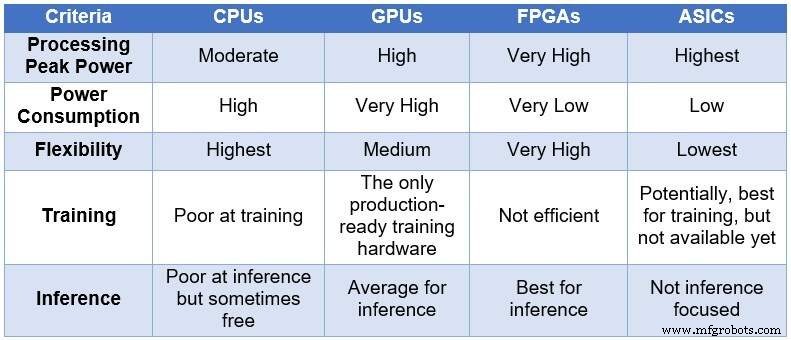
CPU, GPU, FPGA, ASIC의 DL 컴퓨팅 비교 (출처: Lauro Rizzatti)
- CPU는 최대 유연성을 제공하지만 DL 워크로드에서 높은 지연시간과 낮은 처리량으로 어려움을 겪습니다.
- GPU는 거대한 병렬성을 제공하지만 상당한 전력을 소비하고 견고한 냉각이 필요합니다.
- ASIC은 좁은 작업에 극도로 효율적일 수 있지만 긴 개발 주기와 고정 아키텍처로 급속히 진화하는 모델에 부적합합니다.
- FPGA는 높은 처리량, 낮은 전력 소모, 재구성 가능성을 결합해 동적 추론 워크로드에 이상적입니다.
FPGA가 추론에서 뛰어난 이유
현대 FPGA는 수백만 로직 요소, 수천 DSP 블록, 임베디드 메모리와 ARM 코어를 포함하며 모두 병렬로 동작합니다. 단일 클럭 사이클이 수백만 동시 연산을 트리거해 DL 워크로드에 자연스럽게 매핑되는 초당 수조 회 계산을 가능하게 합니다.
CPU와 GPU 대비 FPGA의 주요 이점:
- 임의 데이터 정밀도 지원으로 저정밀도 산술 허용해 처리량 증대
- 동일 워크로드 대비 CPU나 GPU 솔루션보다 5~10배 낮은 전력 엔벨로프
- 재구성 가능성: 새 실리콘 제조 없이 새 모델 지원 위해 동일 장치 업데이트 가능
- 장치 확장성: 하이엔드 데이터센터 카드부터 컴팩트 엣지 모듈까지 FPGA는 광범위한 배포 시나리오에 적합
과제와 트레이드오프
장점에도 불구하고 FPGA는 가파른 학습 곡선을 제시합니다. 고성능 설계 개발에는 전문 하드웨어 기술 언어와 병렬성에 대한 깊은 이해가 필요하며, 소프트웨어 중심 워크플로에 익숙한 팀에게 장벽이 될 수 있습니다.
그럼에도 속도, 유연성, 에너지 효율의 조합을 요구하는 조직에게 FPGA는 오늘날 딥러닝 추론을 위한 가장 매력적인 플랫폼입니다.



