


임베디드

산업 제조
머신러닝과 딥러닝은 이제 일상 기술에 깊이 스며들었습니다. 자연어 비서부터 실시간 객체 감지까지 AI는 점점 더 많은 소비자 및 산업 디바이스를 구동합니다. 하지만 이러한 애플리케이션 대부분은 클라우드 기반 추론 엔진에 의존합니다. 이는 프라이버시, 전력 소비, 지연시간, 비용에 대한 우려를 제기합니다.
AI를 에지에서 로컬로 배포하면 이러한 문제를 해결할 수 있습니다. 주요 걸림돌은 기존 디지털 신경망 가속기의 메모리 주도 전력 소모입니다. 가중치와 활성화가 DRAM이나 SRAM에서 페치될 때 데이터 이동만으로 산술 연산보다 2-3배 더 많은 에너지를 소비합니다. 아날로그 인메모리 컴퓨팅은 비휘발성 메모리 어레이 내부에서 곱셈-누산(MAC) 연산을 직접 수행하여 이 병목현상을 해결합니다.
에지 디바이스가 원시 데이터를 원격 서버로 전달할 때 여러 문제가 발생합니다:
이러한 과제를 극복하기 위해 훈련된 모델은 먼저 고성능 플랫폼(클라우드, GPU 팜 등)에서 구축됩니다. 결과 가중치는 로컬에서 연산을 수행하는 경량 추론 엔진에 매핑됩니다.
경량 모델조차 MAC이 지배적입니다. 예를 들어 224×224 입력을 가진 MobileNet-v1은 420만 파라미터를 가지며 추론당 5억 6,900만 MAC을 요구합니다. 곱셈과 누산은 밀집 행렬-벡터 곱에서 수행됩니다.
기존 가속기에서 가중치와 활성화는 DRAM/SRAM에 저장되며 산술 논리 유닛(ALU)으로 페치되어야 합니다. 그림 3은 메모리 병목을 보여줍니다: 데이터 이동 에너지(전송당 50-100pJ)가 MAC 연산당 250fJ를 압도합니다. 적극적인 데이터 재사용 기법에도 폰 노이만 아키텍처는 전력 효율에 하드 한계를 부과합니다.
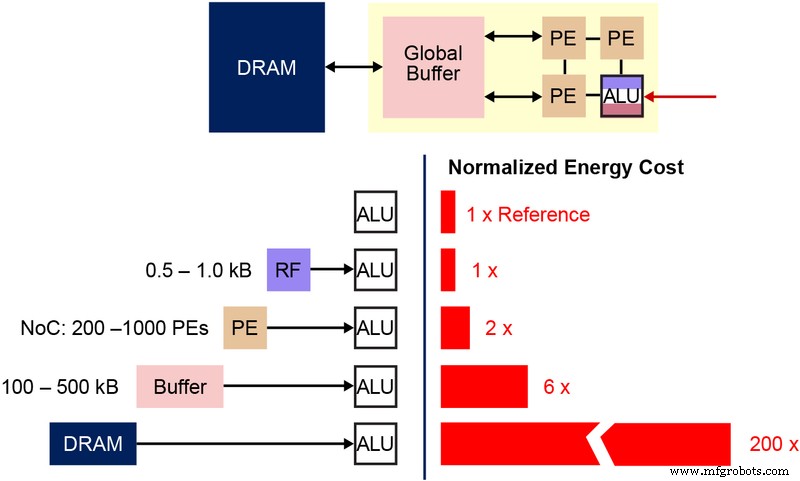 그림 3: 머신러닝 연산의 메모리 병목. (출처: Y.-H. Chen, J. Emer, V. Sze, "Eyeriss: A Spatial Architecture for Energy-Efficient Dataflow for Convolutional Neural Networks," ISCA, 2016.)
연산을 메모리 어레이 자체에 임베드함으로써 가중치를 셔틀링할 필요가 사라집니다. 남은 데이터 전송은 일반적으로 센서 출력인 입력 신호로 제한됩니다. 서브스레숄드 영역에서 동작하는 플래시 셀은 서브-나노암페어 전류를 소비하여 능동 전력을 무시할 수 있게 합니다. 대기 시 비휘발성 셀이 전력 소모 없이 데이터를 유지합니다.
Silicon Storage Technology(Microchip 자회사)의 memBrain™ 플랫폼이 이 접근법을 구현합니다. SuperFlash®(ESF3) 메모리 기술 기반으로 각 비트셀은 정확한 임계 전압(Vt)으로 프로그래밍되어 가중치를 나타내는 컨덕턴스를 설정합니다. 입력 전압이 인가되면 셀을 통한 전류가 입력과 저장된 가중치의 곱과 같습니다.
그림 4는 ESF3 비트셀의 단면을 보여줍니다. 셀은 5개 단자(Control Gate, Word Line, Erase Gate, Source Line, Bitline)를 포함합니다. 고전압 EG가 플로팅 게이트를 프로그래밍하고, 다른 단자의 저전압 바이어싱으로 셀을 읽거나 씁니다.
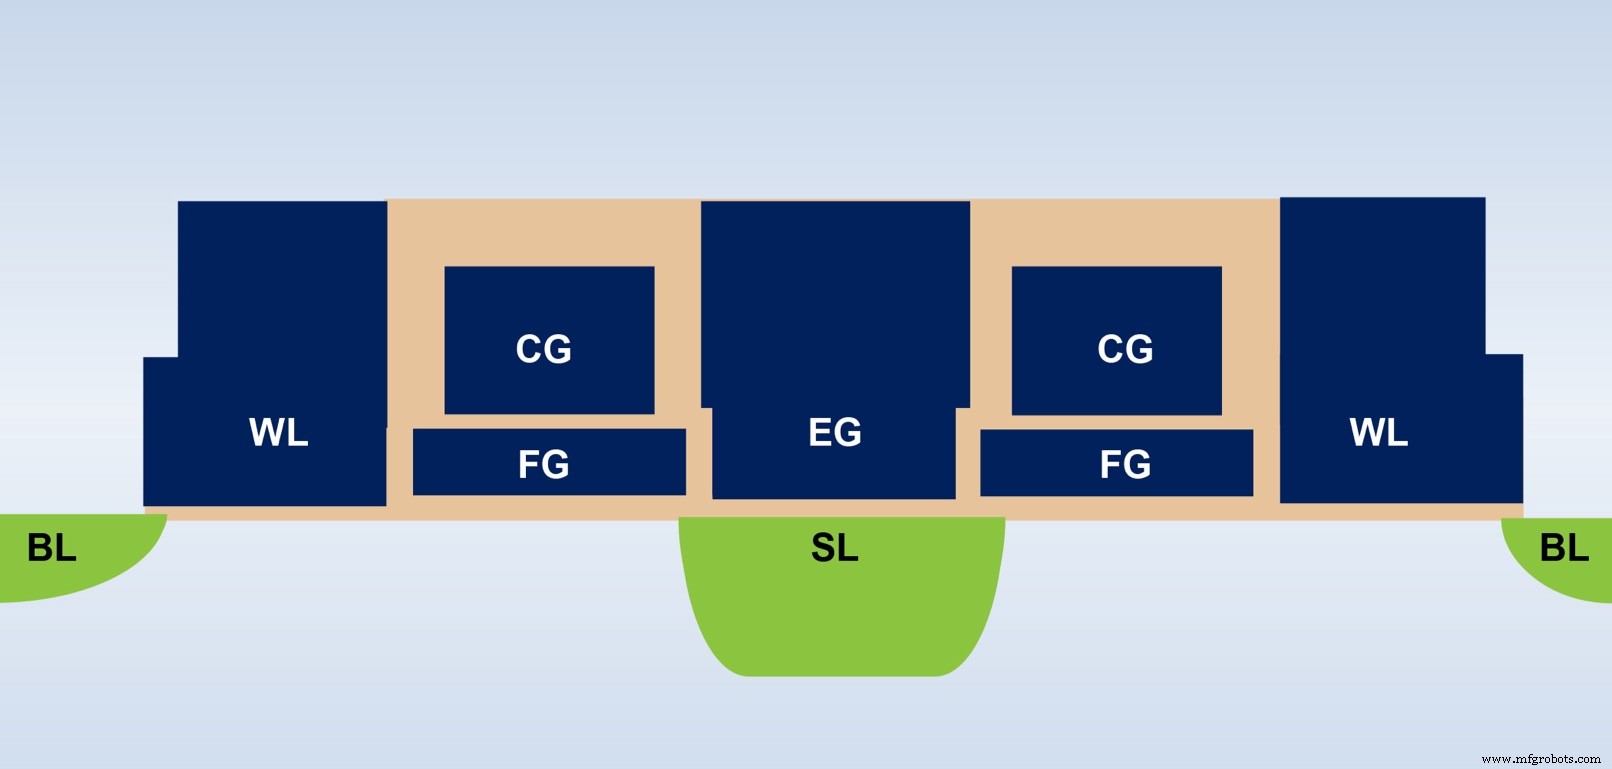 그림 4: SuperFlash ESF3 셀. (출처: Microchip Technology)
미세한 프로그래밍으로 플로팅 게이트 Vt를 조정하여 특정 I-V 곡선을 생성합니다. 그림 5는 고정된 CG 전압 인가 시 4개의 뚜렷한 Vt 레벨이 4개의 별도 전류 응답을 산출하는 2비트 예제를 보여줍니다.
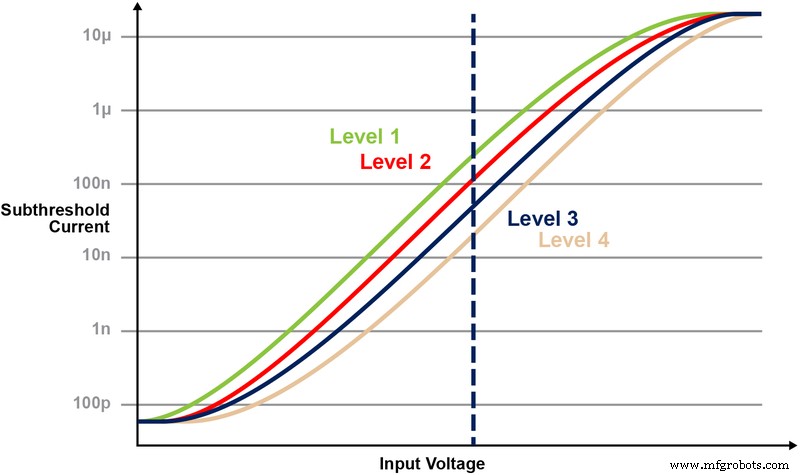 그림 5: ESF3 셀의 Vt 레벨 프로그래밍. (출처: Microchip Technology)
각 셀의 컨덕턴스 gm은 훈련된 가중치를 구현합니다. 전류 Iout = gm · Vin이 곱셈 단계를 구현합니다. 많은 셀을 병렬로 배선하면 컬럼 전류가 자연스럽게 합산되어 누산 연산을 생성합니다. 그림 6은 2×2 어레이가 두 MAC과 한 누산을 수행하는 것을 시각화합니다.
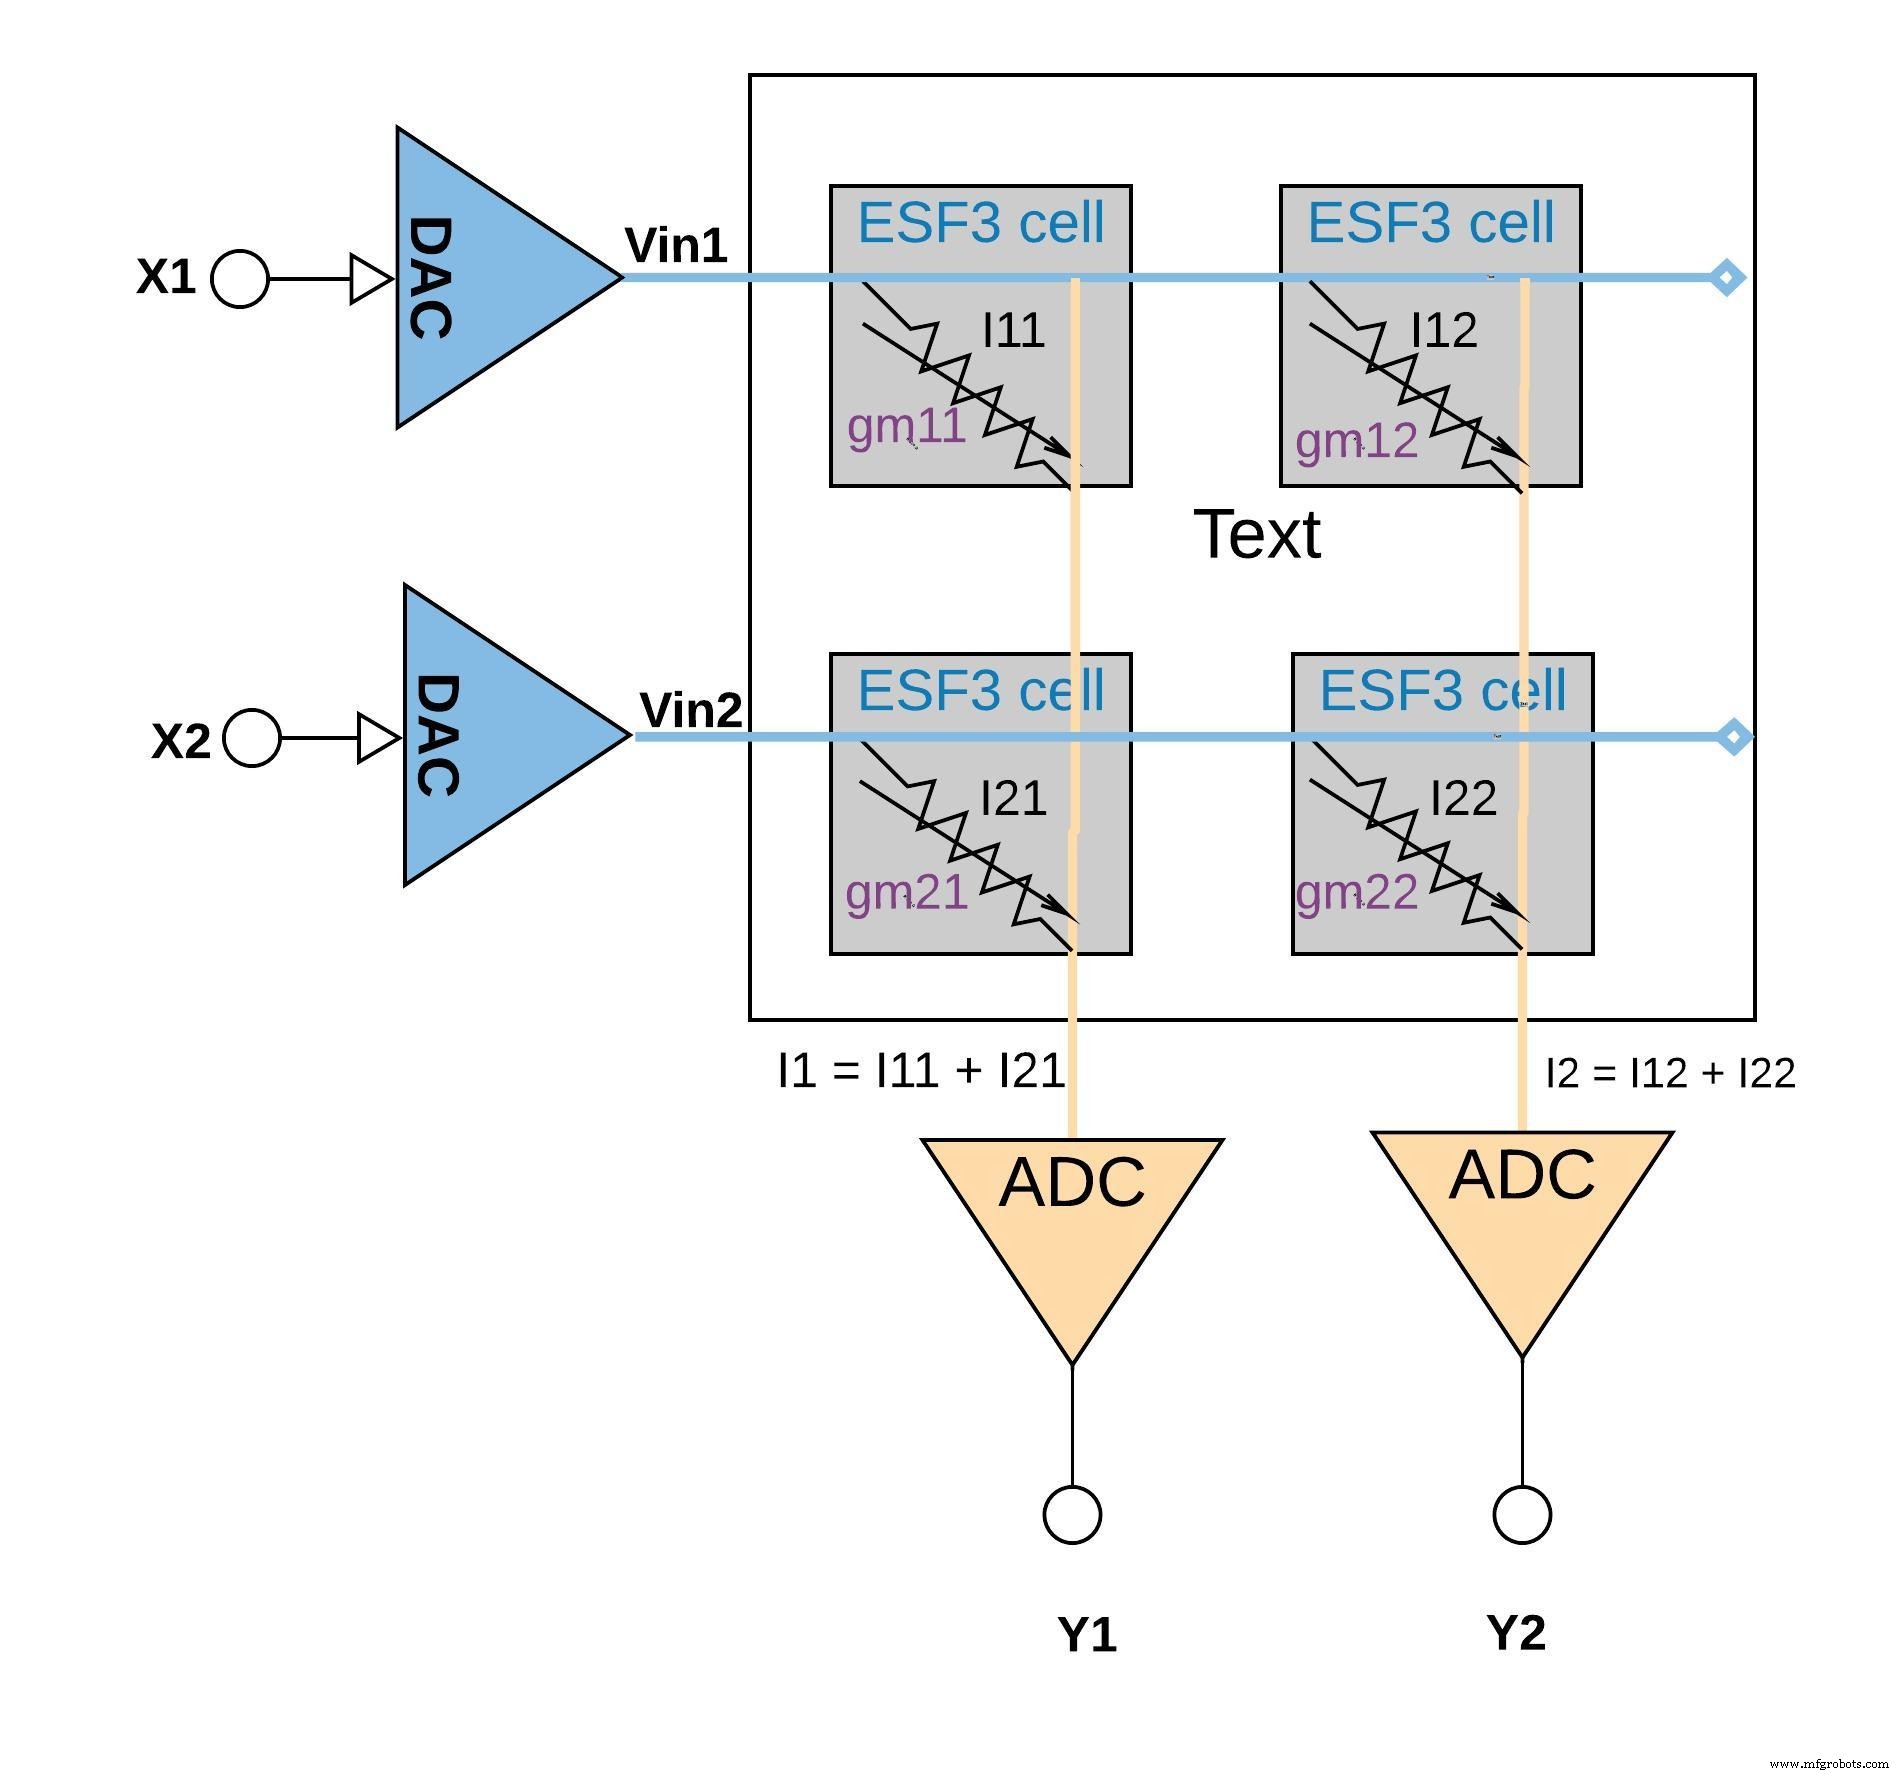 그림 6: ESF3 어레이로 곱셈-누산 연산 (2×2). (출처: Microchip Technology)
더 큰 규모에서 가중치 행렬을 단일 메모리 어레이에 매핑할 수 있습니다. 그림 7은 완전 연결 레이어의 행렬 레이아웃을 보여줍니다.
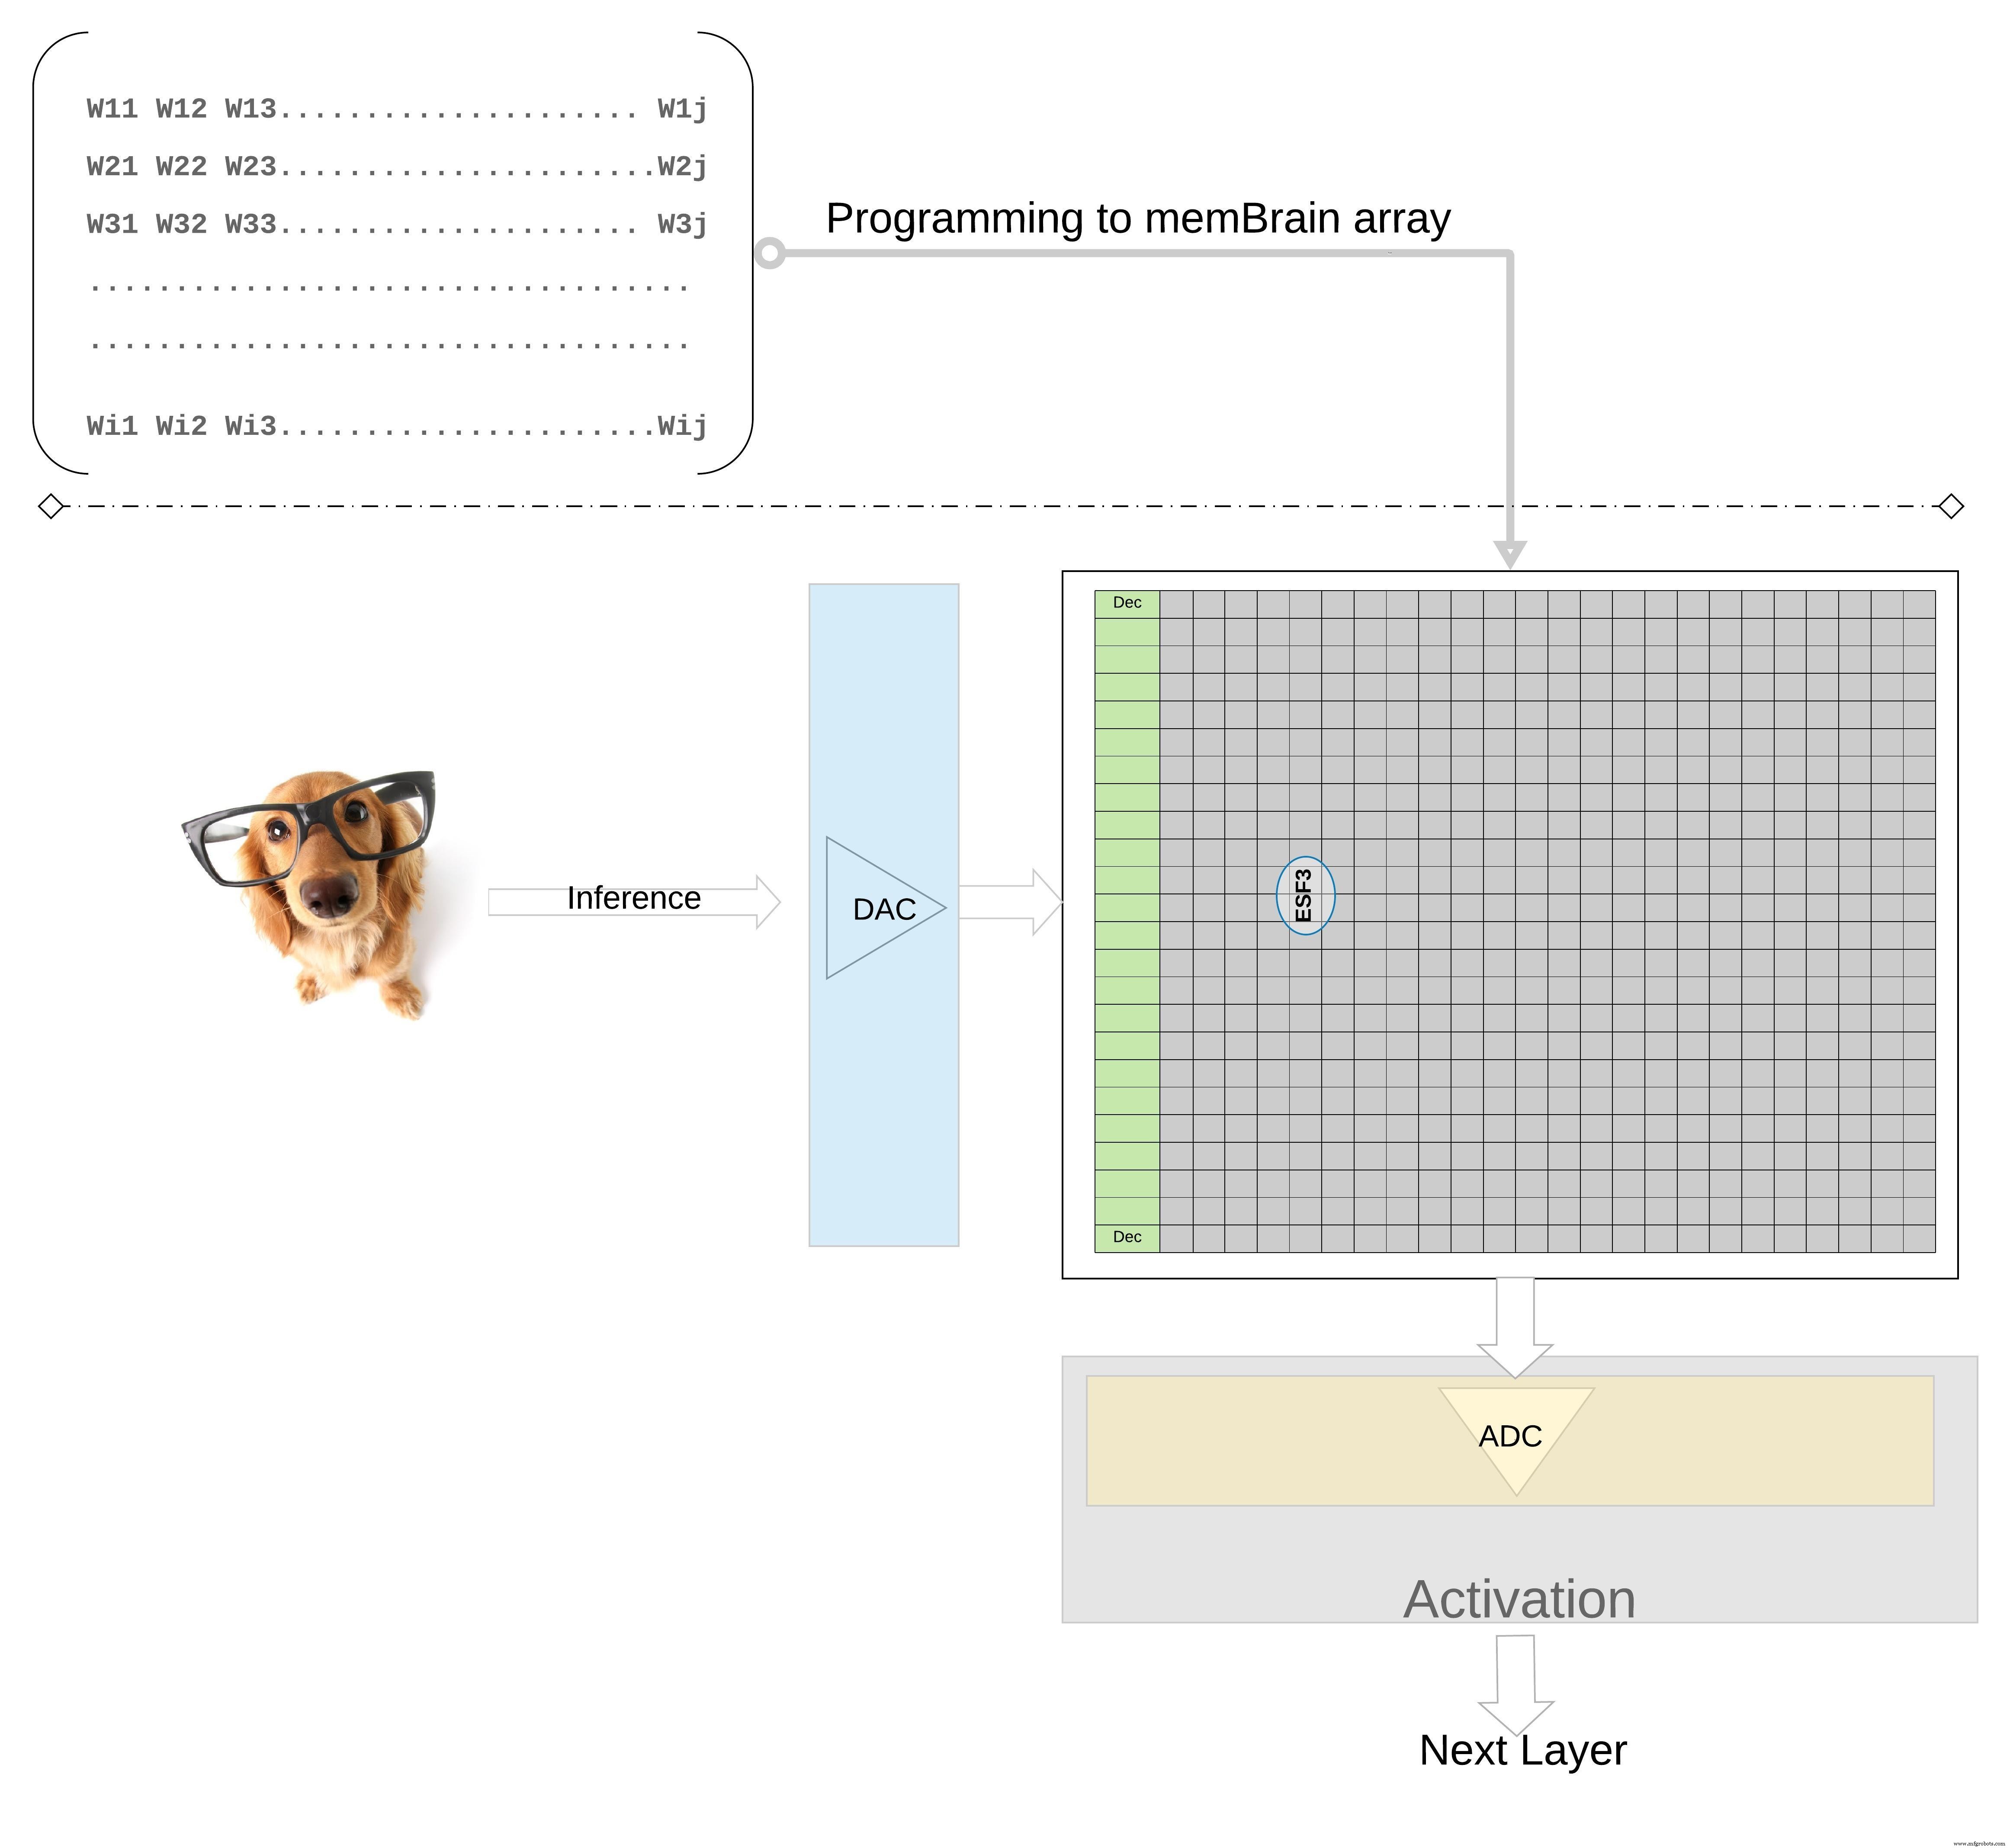 그림 7: 추론용 가중치 행렬 메모리 어레이. (출처: Microchip Technology)
추론 흐름은 간단합니다: 센서 데이터가 디지털화되고, DAC로 아날로그 전압으로 변환되어 어레이에 공급되고, 결과 컬럼 전류가 ADC로 디지털화되어 후속 활성화와 풀링 단계로 전달됩니다.
memBrain 타일은 스택되도록 설계되었습니다. 그림 8은 여러 타일이 공통 아날로그-디지털 상호연결을 공유하는 3×4 구성을 보여줍니다. 데이터는 공유 버스를 통해 타일 간 이동하여 단일 모놀리식 다이 없이 깊은 네트워크 구축을 가능하게 합니다.
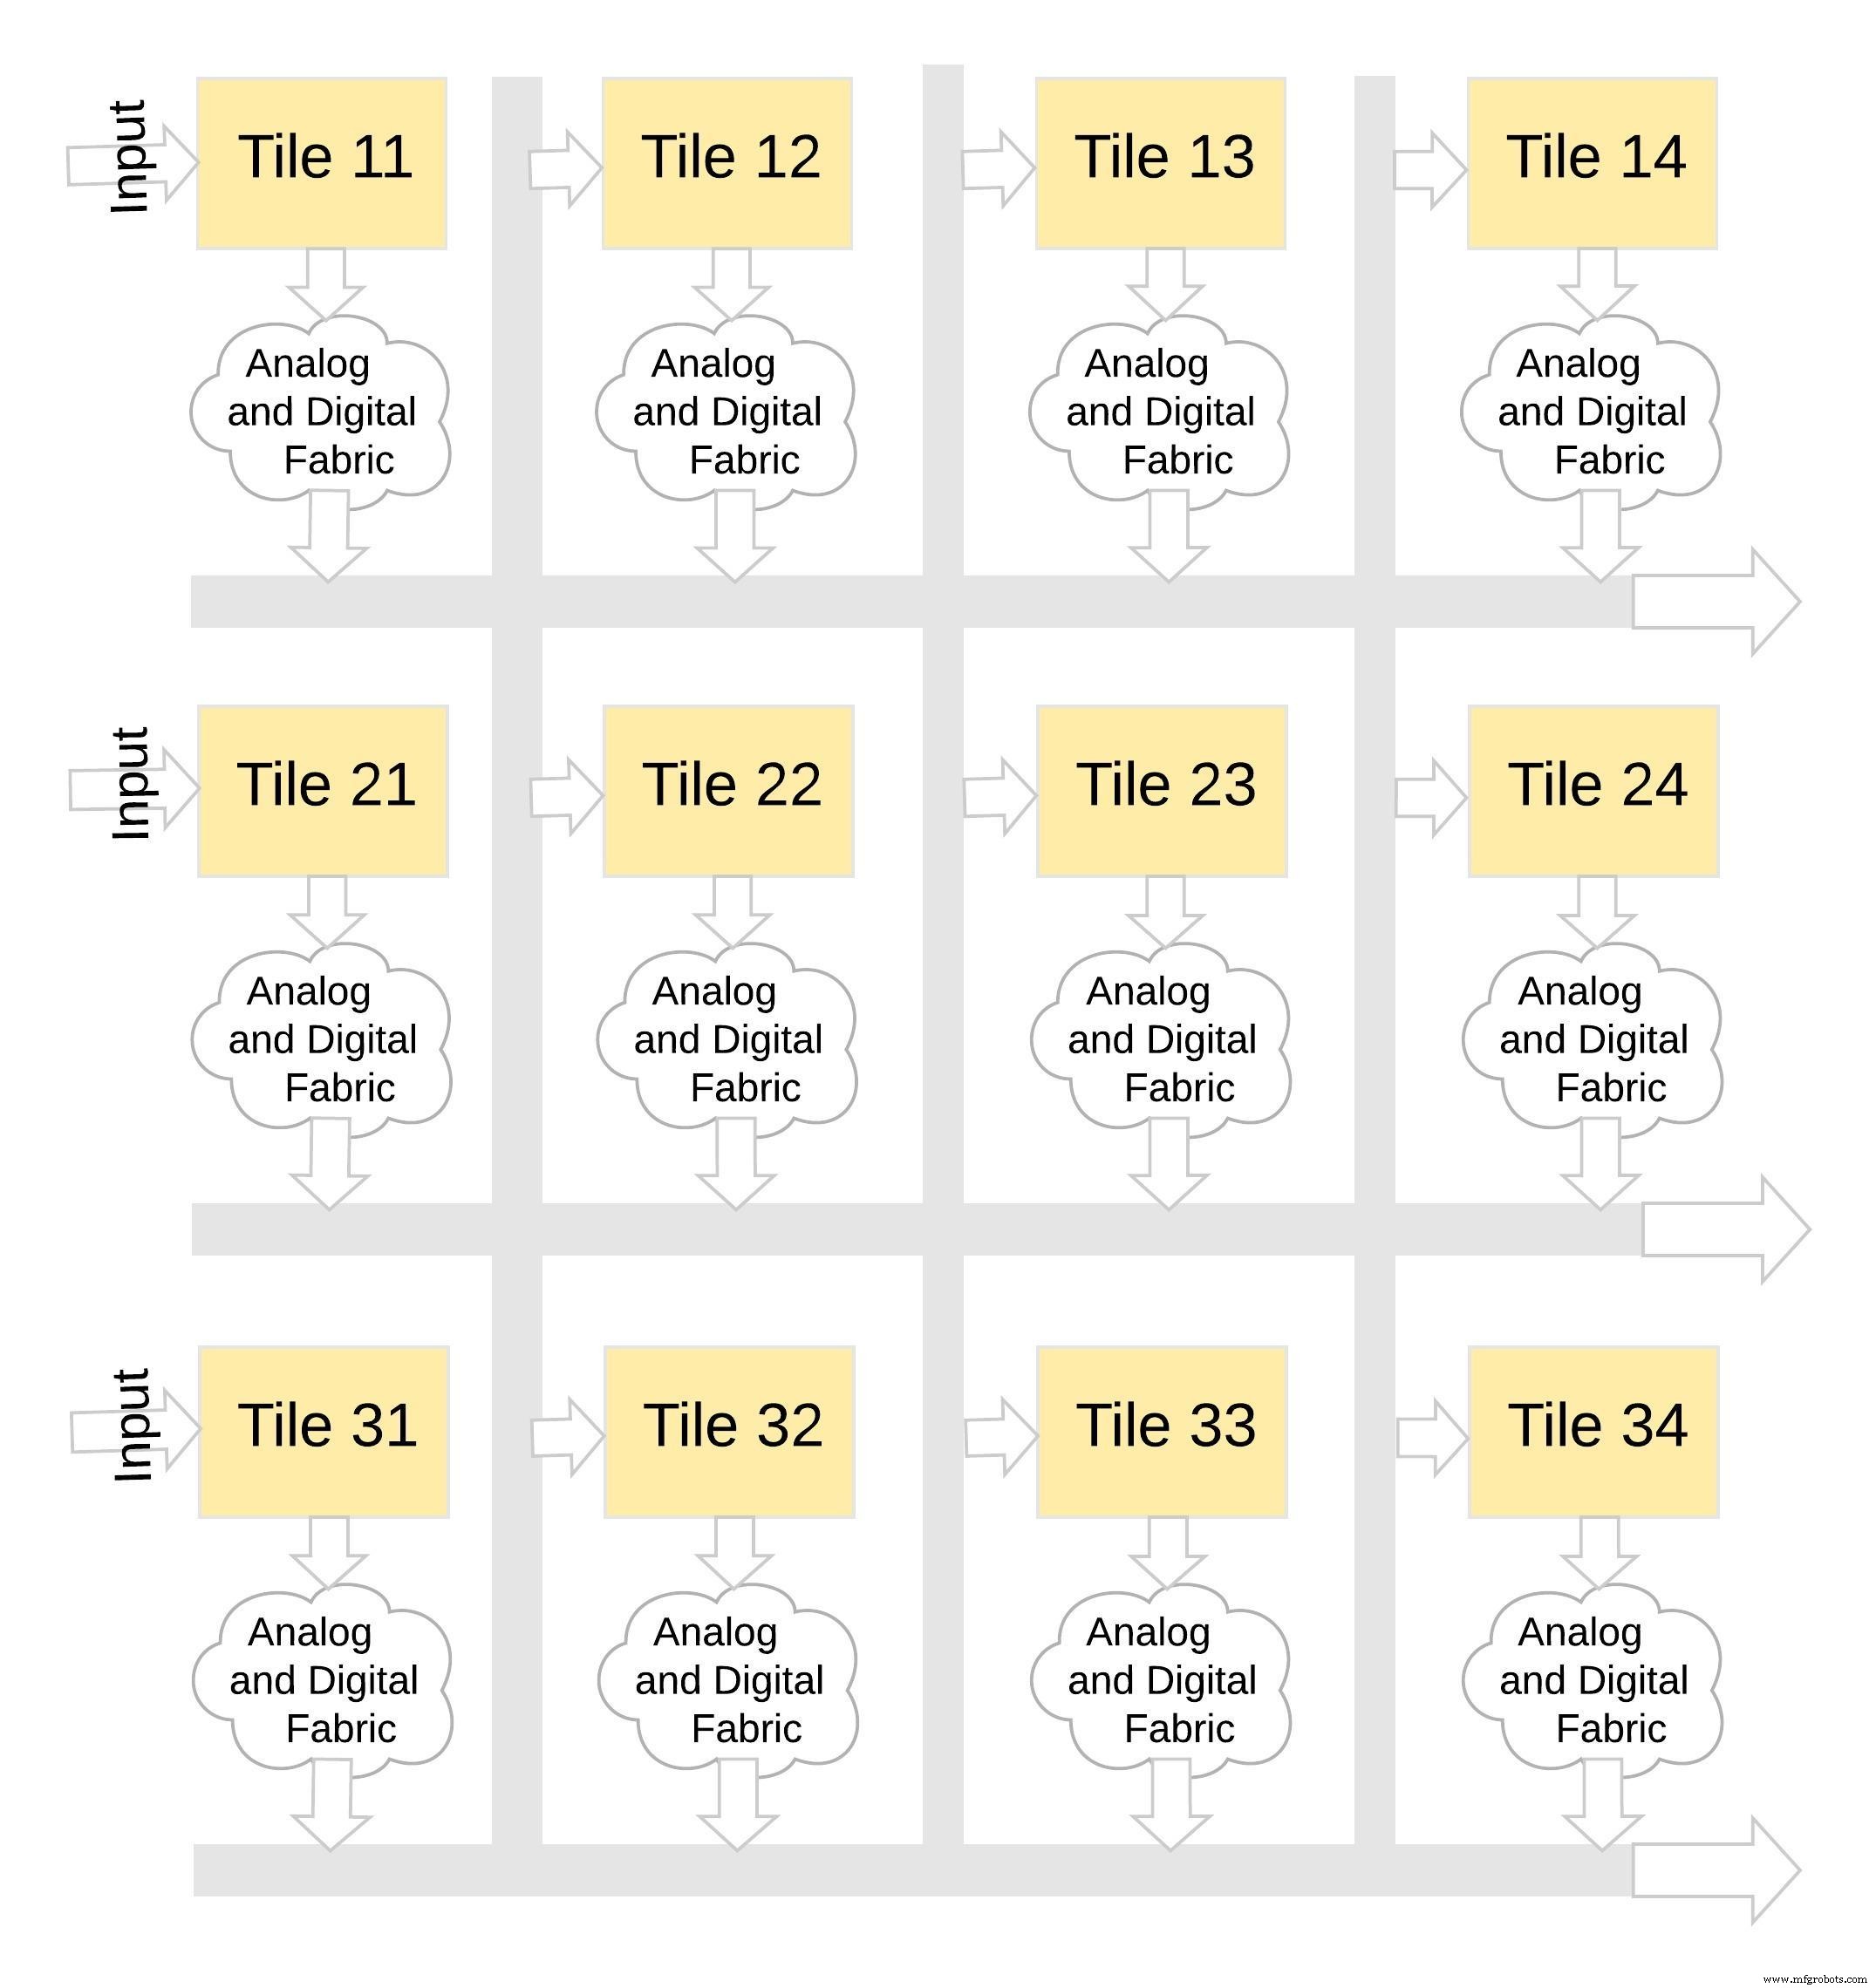 그림 8: memBrain™은 모듈식입니다. (출처: Microchip Technology)
동반 SDK는 프레임워크 불가지론적입니다. TensorFlow, PyTorch, 다른 라이브러리에서 훈련하든 SDK는 모델 양자화, 매핑, memBrain 하드웨어 배포를 처리합니다. 그림 9는 훈련부터 추론까지 워크플로를 개괄합니다.
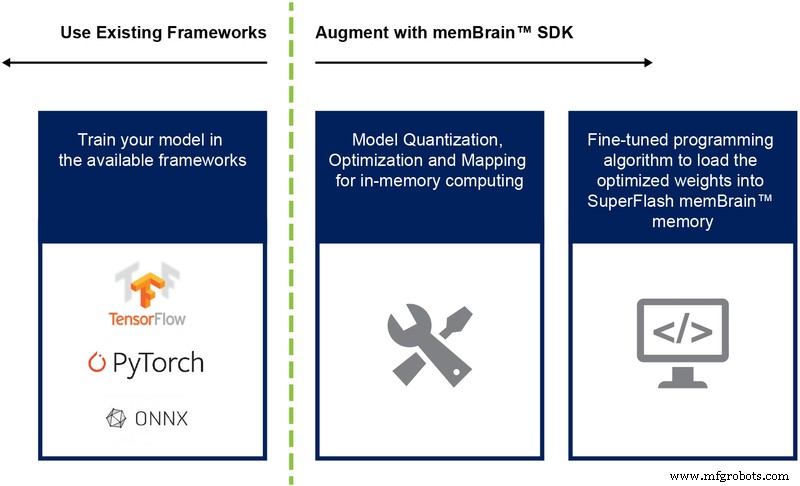 그림 9: memBrain™ SDK 흐름. (출처: Microchip Technology)
에지 AI는 변혁적 애플리케이션을 약속하지만 전력과 비용이 여전히 제한 요소입니다. 검증된 멀티레벨 플래시 기술로 뒷받침되는 아날로그 인메모리 컴퓨팅은 지능형 추론을 센서 바로 옆으로 가져올 실용적이고 저비용의 경로를 제공합니다.
임베디드
스마트 자동차, 스마트 홈 디바이스, 연결된 산업 장비가 수와 인기 모두에서 증가함에 따라, 이들은 사실상 모든 곳에서 데이터를 생성합니다. 사실 2022년 전 세계적으로 164억 개 이상의 연결된 IoT(사물인터넷) 디바이스가 있으며, 이 수는 2025년까지 309억 개로 급증할 것으로 예상됩니다. 그때쯤이면 IDC는 이러한 디바이스가 전 세계적으로 73.1 제타바이트의 데이터를 생성할 것으로 예측하며, 이는 불과 몇 년 전인 2019년 대비 300% 성장한 수치입니다. 이 데이터를 빠르고 효과적으로 정렬하고 분석하는 것은 최적의
빅데이터는 연결된 장치에서 수집된 대규모 데이터셋을 분석하여 데이터 기반 인사이트를 생성하는 것을 의미합니다. 업계 리더들은 빅데이터를 사용하여 패턴과 소비자 행동을 식별하고, 과거 트렌드를 분석하여 운영 효율성을 최적화하며, 비즈니스 관행을 개선합니다. 통계 분석과 소비자 연구의 결합체인 빅데이터는 가치 창출의 열쇠입니다. 특히 제조 부문에서 실행 가능한 빅데이터 인사이트를 활용하는 것이 더 높은 시간 및 비용 절감의 열쇠가 될 수 있습니다. 허니웰(Honeywell)과 KRC가 공동 수행한 연구에 따르면 빅데이터 분석을 효과적으