기업들이 데이터 보안과 자동화 촉진을 위해 맞춤형 음성 에이전트를 구축하는 이유
자동화와 음성: 차세대 프론티어
즉각적인 답변과 신속한 행동이 요구되는 세상에서 자동화는 더 이상 선택이 아닙니다. 필수입니다. 그럼에도 많은 기업과 소비자는 레거시 시스템, 사용성 우려, 가장 중요하게는 데이터 소유권과 보안 때문에 주저합니다. 음성 기술은 데이터를 로컬에 안전하게 유지하면서 속도에 대한 필요를 충족하는 솔루션을 제공합니다.
음성으로의 전환을 이끄는 자동화
IoT(사물인터넷)와 AI(인공지능)가 융합되면서 연결된 디바이스와 그들이 생성하는 데이터의 양이 폭발적으로 증가합니다. 음성 지원 인터페이스는 화면을 터치하지 않고 환경과 상호작용할 수 있게 하는 자연스러운 다음 단계입니다. 선도 기업들은 이제 Alexa, Google Voice, Cortana 같은 주류 비서를 넘어 데이터를 사내에 유지하는 맞춤형 음성 플랫폼에 투자하고 있습니다.
음성 제어에 대한 수요 증가
음성은 차세대 지배적 인간-컴퓨터 인터페이스로 부상하고 있습니다. 터치스크린과 달리 말하기는 더 직관적이며 요리부터 크루즈 선박 선실 탐색까지 핸즈프리 시나리오에서 사용할 수 있습니다. 자연어 처리(NLP)가 충분히 성숙하여 음성 대화가 거의 인간처럼 느껴지며, 하부의 음성-텍스트 시스템은 복잡한 작업에 필요한 정밀도를 제공합니다.
맞춤형 음성 에이전트의 핵심 구성요소
견고하고 안전한 음성 에이전트 구축에는 세 가지 핵심 기술이 필요합니다:
- 원거리 알고리즘 – 주변 소음을 억제하며 거리에서 명확한 음성 포착. Harman Embedded Audio에서는 4가지 특허받은 Sonique 알고리즘을 배포: 노이즈 억제, 어쿠스틱 노이즈 캔슬링, 사운드 분리, 빔포밍, 음성 활동 감지.
- 키워드 스포팅(KWS) – '헤이 조' 같은 웨이크 워드를 듣는 경량 딥 뉴럴 모델. 시끄러운 환경에서 낮은 오수락률과 오거부률로 KWS 튜닝이 중요.
- 자동 음성 인식(ASR) & NLU – E-NOVA 엔진이 음성을 텍스트로 변환, 의도로 매핑, 음성 응답 생성. 다국어, 온프레미스 배포, 화자 식별 지원.
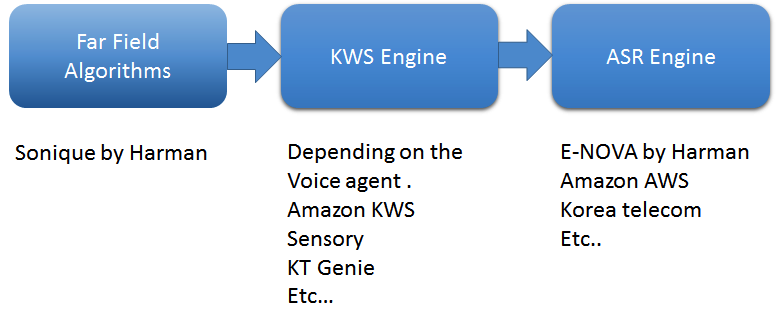 그림 1: 음성 에이전트의 기본 처리 파이프라인. (출처: Harman Embedded Audio)
실제 환경에 적응
모든 애플리케이션은 고유한 음향 과제를 제시합니다. 분주한 주방에서는 끓는 냄비, 가전제품, 대화를 필터링해야 합니다. 크루즈 선박에서는 엔진 굉음과 바람이 훨씬 더 적대적인 노이즈 플로어를 만듭니다. 알고리즘 미세 조정, 마이크 전략적 배치, 높은 신호-잡음비 스피커 사용으로 ASR 엔진에 가능한 가장 깨끗한 오디오를 전달하여 정확한 응답을 보장합니다.
MSC 크루즈를 위한 맞춤형 비서가 이 과정을 시연합니다:
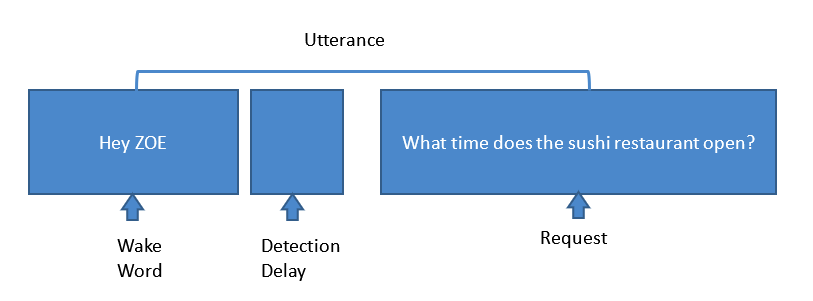 그림 2: 일반적인 음성 비서 요청에 포함된 단계들. (출처: Harman Embedded Audio)
성공 측정: 오거부율
웨이크 워드 신뢰성은 오거부율(FRR)로 정량화됩니다. 업계 수준 FRR 달성은 다양한 데이터로 훈련하고 최상위 알고리즘을 통합하는 것을 요구합니다. 다양한 음향 조건 하의 엄격한 실험실 테스트로 시스템이 표준을 충족하거나 초과함을 확인합니다.
독자적 음성 플랫폼의 이점
맞춤형 음성 에이전트는 다음을 제공합니다:
- 자연스러운 핸즈프리 상호작용으로 향상된 사용자 경험
- 데이터 완전 제어 – 로컬 저장, 보호, 서비스 개선에 활용
- 크로스 플랫폼 호환성으로 스마트 스피커, 랩톱, 스마트폰에서 일관된 동작
- 사용자 선호도와 사용 패턴에 적응하는 지속적 학습
독자적 음성 에이전트에 투자함으로써 기업은 자동화의 완전한 잠재력을 열면서 가장 가치 있는 자산인 데이터를 보호할 수 있습니다.



