순환 버퍼는 순차 프로그래밍 언어에서 큐를 생성하는 데 널리 쓰이지만, 하드웨어에서도 구현할 수 있습니다. 이 글에서는 VHDL로 링 버퍼를 만들어 블록 RAM에 FIFO를 구현하는 방법을 다룹니다.
FIFO를 구현할 때는 여러 설계 결정을 내려야 합니다. 어떤 인터페이스가 필요한가? 리소스 제약이 있는가? 오버리드와 오버라이트에 강건해야 하는가? 레이턴시가 허용되는가? 이런 질문들이 FIFO 설계 시 떠오릅니다.
온라인에는 무료 FIFO 구현체와 Xilinx LogiCORE 같은 FIFO 생성기가 많지만, 여전히 많은 엔지니어가 직접 FIFO를 만듭니다. 기본적인 인큐/디큐 작업은 같지만, 세부 사항을 고려하면 구현체가 크게 달라질 수 있기 때문입니다.
링 버퍼 동작 원리
링 버퍼는 연속된 메모리를 사용하여 버퍼링된 데이터를 저장하며, 데이터 이동을 최소화하는 FIFO 구현입니다. 새로운 요소는 읽혀서 FIFO에서 제거될 때까지 같은 메모리 위치에 머뭅니다.
FIFO 내 데이터 위치와 개수를 추적하기 위해 두 개의 카운터를 사용합니다. 이 카운터들은 데이터가 저장된 메모리 공간의 시작점으로부터의 오프셋을 가리킵니다. VHDL에서는 배열 인덱스가 됩니다. 앞으로 이 카운터들을 포인터라고 부르겠습니다.
두 포인터는 헤드(head)와 테일(tail) 포인터입니다. 헤드는 항상 다음에 기록될 데이터가 들어갈 메모리 슬롯을 가리키고, 테일은 FIFO에서 읽혀질 다음 요소를 가리킵니다. 다른 변형도 있지만 이 방식을 사용하겠습니다.
빈 상태
헤드와 테일이 같은 요소를 가리키면 FIFO가 비어 있습니다. 위 그림은 8개 슬롯을 가진 FIFO 예시로, 헤드와 테일 모두 요소 0을 가리키며 초기 상태를 나타냅니다.
두 포인터가 다른 인덱스(예: 3)에 있어도 FIFO는 비어 있습니다. 쓰기마다 헤드 포인터가 한 칸 앞으로 이동하고, 읽기마다 테일 포인터가 증가합니다. 포인터가 최고 인덱스에 도달하면 다음 쓰기/읽기 시 최저 인덱스로 돌아갑니다. 이게 링 버퍼의 장점입니다: 데이터는 움직이지 않고 포인터만 움직입니다.
헤드가 테일을 앞섬
다섯 번 쓴 후의 링 버퍼입니다. 테일은 여전히 슬롯 0, 헤드는 슬롯 5를 가리킵니다. 데이터가 있는 슬롯은 연한 파란색으로 표시했습니다. 테일은 가장 오래된 요소를, 헤드는 다음 빈 슬롯을 가리킵니다.
헤드 인덱스가 테일보다 크면 헤드에서 테일을 빼서 요소 개수를 구할 수 있습니다. 그림에서는 5개입니다.
테일이 헤드를 앞섬
헤드에서 테일을 빼는 건 헤드가 앞설 때만 유효합니다. 위 그림에서 헤드는 2, 테일은 5이므로 2-5=-3이 되어 말이 안 됩니다.
해결책은 헤드에 전체 슬롯 수(여기선 8)를 더하는 것입니다. (2+8)-5=5로 올바른 개수가 나옵니다.
테일은 영원히 헤드를 쫓습니다. 절반의 시간 동안 테일 인덱스가 헤드보다 큽니다. 데이터는 두 포인터 사이에 연한 파란색으로 표시된 영역에 저장됩니다.
가득 찬 상태
가득 찬 링 버퍼는 테일이 헤드 바로 다음 인덱스를 가리킵니다. 이 방식의 결과로 모든 슬롯을 데이터 저장에 쓸 수 없고, 최소 한 슬롯은 비워야 합니다. 위 그림에서 노란색으로 표시된 슬롯이 비어 있지만 사용할 수 없는 슬롯입니다.
전용 빈/가득 신호를 써서 가득 찬 상태를 알릴 수도 있습니다. 그럼 모든 메모리 슬롯에 데이터를 저장할 수 있지만, 레지스터와 LUT 형태의 추가 로직이 필요합니다. 그래서 우리는 한 칸 비우기 방식을 쓰겠습니다. 블록 RAM만 낭비하니까 더 저렴합니다.
링 버퍼 FIFO 구현
FIFO의 입출력 인터페이스 신호를 어떻게 정의하느냐에 따라 링 버퍼의 가능한 구현 수가 제한됩니다. 여기서는 고전적인 읽기/쓰기 인에이블과 빈/가득/유효 인터페이스의 변형을 쓰겠습니다.
입력 측에는 FIFO에 푸시할 데이터를 실어 나르는 쓰기 데이터 버스가 있고, 어서트되면 FIFO가 입력 데이터를 샘플링하는 쓰기 인에이블 신호가 있습니다.
출력 측에는 FIFO가 제어하는 읽기 데이터와 읽기 유효 신호, 그리고 FIFO 하류 사용자가 제어하는 읽기 인에이블 신호가 있습니다.
빈(empty)과 가득(full) 제어 신호는 고전적 FIFO 인터페이스의 일부로, 우리도 사용합니다. FIFO가 제어하며, 리더와 라이터에게 FIFO 상태를 알립니다.
백프레셔(Back Pressure)
FIFO가 비거나 가득 차기를 기다렸다가 조치하면 인터페이싱 로직이 반응할 시간이 없습니다. 순차 로직은 클록 사이클 단위로 동작하므로, 클록의 상승 에지가 설계의 이벤트를 타임스텝으로 분리합니다.
해결책 중 하나는 거의 빈(almost empty)과 거의 가득(almost full) 신호를 추가하여 원래 신호보다 한 클록 사이클 앞서게 하는 것입니다. 이렇게 하면 연속 읽기/쓰기 중에도 외부 로직이 반응할 시간을 벌 수 있습니다.
우리 구현에서는 이 선행 신호들을 접두사 대신 접미사 방식을 선호해 empty_next와 full_next라고 명명했습니다.
엔티티(Entity)
아래 그림은 우리 링 버퍼 FIFO의 엔티티입니다. 포트의 입출력 신호 외에 두 개의 제네릭 상수가 있습니다. RAM_WIDTH 제네릭은 입력/출력 워드의 비트 수, 즉 각 메모리 슬롯이 담을 비트 수를 정의합니다.
RAM_DEPTH 제네릭은 링 버퍼에 예약할 슬롯 수를 정의합니다. 한 슬롯은 가득 찬 상태 표시에 예약되므로 FIFO 용량은 RAM_DEPTH - 1이 됩니다. RAM_DEPTH 상수는 대상 FPGA의 RAM 깊이에 맞춰야 합니다. 블록 RAM 프리미티브 내 미사용 RAM은 낭비되며 FPGA 내 다른 로직과 공유할 수 없습니다.
entity ring_buffer is generic ( RAM_WIDTH : natural; RAM_DEPTH : natural ); port ( clk : in std_logic; rst : in std_logic; -- Write port wr_en : in std_logic; wr_data : in std_logic_vector(RAM_WIDTH - 1 downto 0); -- Read port rd_en : in std_logic; rd_valid : out std_logic; rd_data : out std_logic_vector(RAM_WIDTH - 1 downto 0); -- Flags empty : out std_logic; empty_next : out std_logic; full : out std_logic; full_next : out std_logic; -- The number of elements in the FIFO fill_count : out integer range RAM_DEPTH - 1 downto 0 ); end ring_buffer;
클록과 리셋 외에 포트 선언에는 고전적인 데이터/인에이블 읽기/쓰기 포트가 포함됩니다. 상위/하위 모듈이 FIFO에 새 데이터를 푸시하거나 가장 오래된 요소를 팝하는 데 쓰입니다.
rd_valid 신호는 rd_data 포트에 유효한 데이터가 있을 때 FIFO가 어서트합니다. 이 이벤트는 rd_en 펄스 후 한 클록 사이클 지연됩니다. 이유는 뒤에서 설명하겠습니다.
그다음은 FIFO가 설정하는 빈/가득 플래그입니다. empty_next는 요소가 1개 이하 남았을 때 어서트되고, empty는 요소가 0개일 때만 활성화됩니다. 마찬가지로 full_next는 1개 이하 공간만 남았을 때, full은 더 이상 데이터를 수용할 수 없을 때 어서트됩니다.
마지막으로 fill_count 출력이 있습니다. 현재 FIFO에 저장된 요소 수를 반영하는 정수입니다. 내부에서 쓰이므로 엔티티로 빼내도 추가 비용이 거의 없고, 인스턴스화 시 이 신호를 미연결로 두면 됩니다.
선언부(Declarative Region)
VHDL 파일의 선언부에서는 링 버퍼 모듈 내부에서 쓸 커스텀 타입, 서브타입, 여러 시그널, 프로시저를 선언합니다.
type ram_type is array (0 to RAM_DEPTH - 1) of std_logic_vector(wr_data'range); signal ram : ram_type; subtype index_type is integer range ram_type'range; signal head : index_type; signal tail : index_type; signal empty_i : std_logic; signal full_i : std_logic; signal fill_count_i : integer range RAM_DEPTH - 1 downto 0; -- Increment and wrap procedure incr(signal index : inout index_type) is begin if index = index_type'high then index <= index_type'low; else index <= index + 1; end if; end procedure;
먼저 RAM을 모델링할 새 타입을 선언합니다. ram_type은 제네릭 입력으로 크기가 정해지는 벡터 배열입니다. 이 타입으로 링 버퍼의 데이터를 담을 ram 시그널을 선언합니다.
다음 블록에서는 index_type이라는 정수의 서브타입을 선언합니다. 그 범위는 RAM_DEPTH 제네릭에 의해 간접적으로 결정됩니다. 이 인덱스 타입으로 헤드와 테일 포인터 두 시그널을 선언합니다.
그다음은 엔티티 시그널의 내부 복사본인 시그널 선언 블록입니다. 엔티티 시그널과 같은 기본 이름에 _i 접미사를 붙여 내부용임을 표시했습니다. 엔티티 시그널에 inout 모드를 쓰는 건 나쁜 스타일로 여겨져 이 방식을 택했습니다.
마지막으로 incr 프로시저를 선언합니다. index_type 시그널을 파라미터로 받아 헤드/테일 포인터를 증가시키고, 최댓값에서 0으로 감아 줍니다. 헤드와 테일은 정수 서브타입이라 랩어라운드 동작을 기본 지원하지 않는데, 이 프로시저로 우회합니다.
동시 문장(Concurrent Statements)
아키텍처 최상단에 동시 문장을 모아 둡니다. 한 줄짜리 시그널 할당이라 간과하기 쉬워 프로세스 전에 모아 두는 편입니다. 동시 문장도 일종의 프로세스입니다.
-- Copy internal signals to output empty <= empty_i; full <= full_i; fill_count <= fill_count_i; -- Set the flags empty_i <= '1' when fill_count_i = 0 else '0'; empty_next <= '1' when fill_count_i <= 1 else '0'; full_i <= '1' when fill_count_i >= RAM_DEPTH - 1 else '0'; full_next <= '1' when fill_count_i >= RAM_DEPTH - 2 else '0';
첫 블록에서는 내부 버전 시그널을 출력으로 복사합니다. 이 라인들은 엔티티 시그널이 내부 버전을 정확히 같은 시간에 따르게 하며, 시뮬레이션에서는 한 델타 사이클 지연이 생깁니다.
두 번째이자 마지막 블록에서는 출력 플래그를 할당해 링 버퍼의 가득/빈 상태를 알립니다. 계산은 RAM_DEPTH 제네릭과 fill_count 시그널을 기반으로 합니다. RAM 깊이는 변하지 않는 상수이므로 플래그는 필 카운트 업데이트만으로 변경됩니다.
헤드 포인터 업데이트
헤드 포인터의 기본 기능은 외부에서 쓰기 인에이블 신호가 어서트될 때마다 증가하는 것입니다. 앞서 선언한 incr 프로시저에 head 시그널을 넘겨 수행합니다.
PROC_HEAD : process(clk) begin if rising_edge(clk) then if rst = '1' then head <= 0; else if wr_en = '1' and full_i = '0' then incr(head); end if; end if; end if; end process;
코드에는 오버라이트 방지를 위한 and full_i = '0' 조건이 추가됐습니다. 데이터 소스가 FIFO가 가득 찰 때 절대 쓰지 않는다면 이 로직은 생략 가능합니다. 보호 없이 오버라이트가 발생하면 링 버퍼가 다시 빈 상태가 됩니다.
링 버퍼가 가득 찬 상태에서 헤드 포인터가 증가하면 헤드가 테일과 같은 요소를 가리키게 되어 모듈이 포함된 데이터를 "잊어버리고" FIFO 필이 빈 것처럼 보입니다.
full_i 시그널을 헤드 포인터 증가 전에 평가하면 덮어쓴 값만 잊게 됩니다. 이쪽이 더 낫다고 봅니다. 어쨌든 오버라이트가 발생하면 이 모듈 외부에서 오작동이 있다는 신호입니다.
테일 포인터 업데이트
테일 포인터도 헤드와 비슷하게 증가하지만, 트리거는 read_en 입력입니다. 오버라이트 보호와 마찬가지로 and empty_i = '0'을 부울 표현식에 포함해 오버리드(over-read)를 방지합니다.
PROC_TAIL : process(clk) begin if rising_edge(clk) then if rst = '1' then tail <= 0; rd_valid <= '0'; else rd_valid <= '0'; if rd_en = '1' and empty_i = '0' then incr(tail); rd_valid <= '1'; end if; end if; end if; end process;
또한 모든 유효한 읽기마다 rd_valid 신호를 펄스합니다. 읽기 데이터는 FIFO가 비어 있지 않다면 rd_en이 어서트된 다음 클록 사이클에 항상 유효합니다. 이 사실을 알면 이 신호가 굳이 필요 없지만 편의상 포함했습니다. 모듈 인스턴스화 시 이 신호가 미연결이면 합성 과정에서 최적화되어 사라집니다.
블록 RAM 추론(Inferring Block RAM)
합성 도구가 블록 RAM을 추론하게 하려면 리셋 없는 동기 프로세스에서 읽기/쓰기 포트를 선언해야 합니다. 매 클록 사이클마다 RAM을 읽고 쓰고, 제어 신호가 이 데이터의 사용을 처리하게 합니다.
PROC_RAM : process(clk) begin if rising_edge(clk) then ram(head) <= wr_data; rd_data <= ram(tail); end if; end process;
이 프로세스는 다음 쓰기가 언제 일어날지 몰라도 됩니다. 그냥 계속 씁니다. 쓰기 결과로 head 시그널이 증가하면 다음 슬롯에 쓰기 시작해 직전에 쓴 값이 고정됩니다.
필 카운트 업데이트
fill_count 시그널은 가득/빈 신호 생성에 쓰이며, 이는 다시 FIFO의 오버라이트/오버리드 방지에 쓰입니다. 필 카운터는 헤드와 테일 포인터에 민감한 조합 프로세스로 업데이트되지만, 그 포인터들은 클록 상승 에지에서만 업데이트됩니다. 따라서 필 카운트도 클록 에지 직후에 변경됩니다.
PROC_COUNT : process(head, tail) begin if head < tail then fill_count_i <= head - tail + RAM_DEPTH; else fill_count_i <= head - tail; end if; end process;
필 카운트는 테일을 헤드에서 빼서 계산합니다. 테일 인덱스가 헤드보다 크면 RAM_DEPTH 상수 값을 더해 현재 링 버퍼에 있는 요소 수를 정확히 구합니다.
링 버퍼 FIFO 전체 VHDL 코드
library ieee; use ieee.std_logic_1164.all; entity ring_buffer is generic ( RAM_WIDTH : natural; RAM_DEPTH : natural ); port ( clk : in std_logic; rst : in std_logic; -- Write port wr_en : in std_logic; wr_data : in std_logic_vector(RAM_WIDTH - 1 downto 0); -- Read port rd_en : in std_logic; rd_valid : out std_logic; rd_data : out std_logic_vector(RAM_WIDTH - 1 downto 0); -- Flags empty : out std_logic; empty_next : out std_logic; full : out std_logic; full_next : out std_logic; -- The number of elements in the FIFO fill_count : out integer range RAM_DEPTH - 1 downto 0 ); end ring_buffer; architecture rtl of ring_buffer is type ram_type is array (0 to RAM_DEPTH - 1) of std_logic_vector(wr_data'range); signal ram : ram_type; subtype index_type is integer range ram_type'range; signal head : index_type; signal tail : index_type; signal empty_i : std_logic; signal full_i : std_logic; signal fill_count_i : integer range RAM_DEPTH - 1 downto 0; -- Increment and wrap procedure incr(signal index : inout index_type) is begin if index = index_type'high then index <= index_type'low; else index <= index + 1; end if; end procedure; begin -- Copy internal signals to output empty <= empty_i; full <= full_i; fill_count <= fill_count_i; -- Set the flags empty_i <= '1' when fill_count_i = 0 else '0'; empty_next <= '1' when fill_count_i <= 1 else '0'; full_i <= '1' when fill_count_i >= RAM_DEPTH - 1 else '0'; full_next <= '1' when fill_count_i >= RAM_DEPTH - 2 else '0'; -- Update the head pointer in write PROC_HEAD : process(clk) begin if rising_edge(clk) then if rst = '1' then head <= 0; else if wr_en = '1' and full_i = '0' then incr(head); end if; end if; end if; end process; -- Update the tail pointer on read and pulse valid PROC_TAIL : process(clk) begin if rising_edge(clk) then if rst = '1' then tail <= 0; rd_valid <= '0'; else rd_valid <= '0'; if rd_en = '1' and empty_i = '0' then incr(tail); rd_valid <= '1'; end if; end if; end if; end process; -- Write to and read from the RAM PROC_RAM : process(clk) begin if rising_edge(clk) then ram(head) <= wr_data; rd_data <= ram(tail); end if; end process; -- Update the fill count PROC_COUNT : process(head, tail) begin if head < tail then fill_count_i <= head - tail + RAM_DEPTH; else fill_count_i <= head - tail; end if; end process; end architecture;
위 코드가 링 버퍼 FIFO의 전체 코드입니다. 아래 양식을 작성하면 ModelSim 프로젝트 파일과 테스트벤치를 즉시 메일로 받아볼 수 있습니다.
테스트벤치
FIFO는 간단한 테스트벤치에 인스턴스화되어 동작을 시연합니다. 아래 양식으로 테스트벤치 소스 코드와 ModelSim 프로젝트를 다운로드할 수 있습니다.
제네릭 입력은 다음 값으로 설정했습니다:
RAM_WIDTH: 16
RAM_DEPTH: 256
테스트벤치는 먼저 FIFO를 리셋합니다. 리셋 해제 후 순차적 값(1-255)을 FIFO가 가득 찰 때까지 쓰고, 마지막으로 FIFO를 비운 뒤 테스트를 마칩니다.
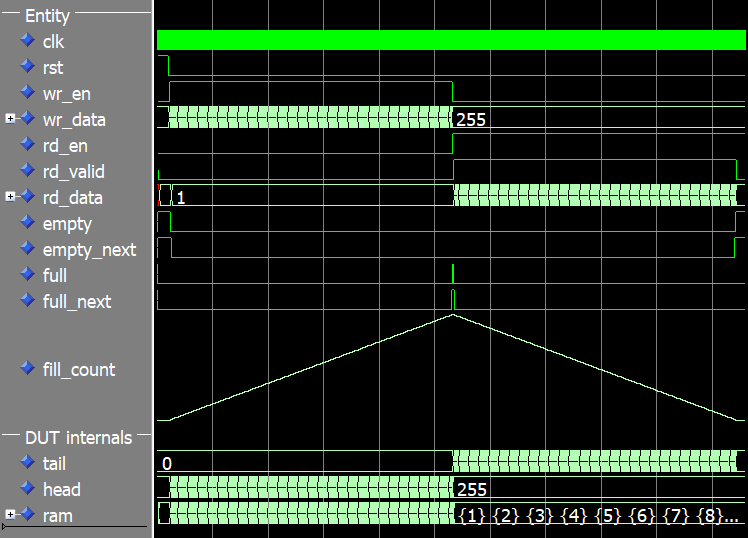
아래 이미지는 테스트벤치 전체 실행의 파형입니다. fill_count 신호는 아날로그 값으로 표시되어 FIFO 필 레벨을 직관적으로 보여줍니다.
시뮬레이션 시작 시 헤드, 테일, 필 카운트는 0입니다. full 신호가 어서트되는 시점에서 헤드 값은 255이고 fill_count도 255입니다. RAM 깊이가 256인데 필 카운트가 255까지만 오르는 건 앞서 논의한 한 칸 비우기 방식 때문입니다.
쓰기를 멈추고 읽기를 시작하는 전환점에서 헤드 값은 고정되고 테일과 필 카운트는 감소하기 시작합니다. 시뮬레이션 끝에서 FIFO가 비면 헤드와 테일 모두 255, 필 카운트는 0이 됩니다.
이 테스트벤치는 시연용일 뿐, 자가 검증 로직이나 FIFO 출력이 올바른지 검증하는 로직은 없습니다.
다음 주 글에서는 제약 랜덤 검증(constrained random verification) 주제로 이 모듈을 사용할 예정입니다. 이는 일반적인 지시 테스트와 다른 테스트 전략으로, 테스트벤치가 DUT(시험 대상 장치)와 랜덤하게 상호작용하고, 별도 테스트벤치 프로세스가 DUT 동작을 검증합니다. 미리 정의된 이벤트 발생 횟수에 도달하면 테스트가 완료됩니다.
후속 블로그 글 읽기: 제약 랜덤 검증
Vivado에서 합성하기
가장 대중적인 FPGA 구현 도구인 Xilinx Vivado에서 링 버퍼를 합성했습니다. 하지만 듀얼 포트 블록 RAM이 있는 모든 FPGA 아키텍처에서 작동해야 합니다.
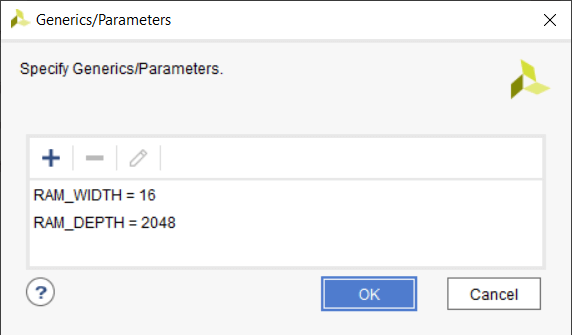
링 버퍼를 독립 모듈로 구현하려면 제네릭 입력에 값을 할당해야 합니다. Vivado에서는 Settings → General → Generics/Parameters 메뉴로 합니다.
RAM_WIDTH 값은 시뮬레이션과 같은 16으로 설정했습니다. RAM_DEPTH는 2048로 했는데, 이는 선택한 Xilinx Zynq 아키텍처의 RAMB36E1 프리미티브 최대 깊이입니다. 더 낮은 값을 써도 같은 수의 블록 RAM을 쓰고, 더 높으면 블록 RAM이 여러 개 쓰입니다.
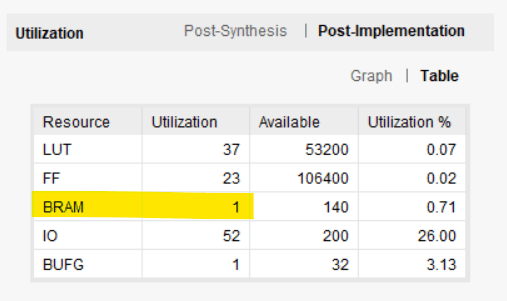
아래 이미지는 Vivado가 보고한 구현 후 리소스 사용량입니다. 우리 링 버퍼가 블록 RAM 1개와 약간의 LUT, 플립플롭을 소모했음을 확인할 수 있습니다.
유효(valid) 신호 없애기
rd_en과 rd_valid 신호 사이의 한 클록 사이클 지연이 정말 필요한지 의문일 수 있습니다. 어차피 rd_en을 어서트할 때 데이터가 rd_data에 이미 있는데, 이 값을 쓰고 링 버퍼가 다음 클록 사이클에 다음 요소로 넘어가게 하면 안 될까요?
엄밀히 말해 valid 신호는 필요 없습니다. 편의상 포함시켰을 뿐입니다. 핵심은 rd_en 신호 어서트 후 다음 클록 사이클까지 기다려야 한다는 점입니다. 그렇지 않으면 RAM이 반응할 시간이 없습니다.
FPGA의 블록 RAM은 완전 동기 컴포넌트라 데이터를 읽고 쓰려면 클록 에지가 필요합니다. 읽기/쓰기 클록이 같은 소스일 필요는 없지만 클록 에지는 있어야 합니다. 게다가 RAM 출력과 다음 레지스터(플립플롭) 사이에 로직이 있으면 안 됩니다. RAM 출력을 클록하는 레지스터가 블록 RAM 프리미티브 내부에 있기 때문입니다.
위 그림은 우리 링 버퍼에서 wr_data 입력이 RAM을 거쳐 rd_data 출력에 나타나기까지의 타이밍 다이어그램입니다. 각 신호가 상승 클록 에지에서 샘플링되므로 쓰기 포트 드라이브 시작부터 읽기 포트 출현까지 3 클록 사이클이 걸리고, 수신 모듈이 이 데이터를 쓰려면 한 클록 사이클이 더 필요합니다.
레이턴시 줄이기
이 문제를 완화하는 방법은 있지만 FPGA에서 추가 리소스 비용이 듭니다. 우리 링 버퍼의 읽기 포트에서 한 클록 사이클 지연을 줄이는 실험을 해보겠습니다. 아래 코드 조각에서 rd_data 출력을 동기 프로세스에서 ram과 tail 시그널에 민감한 조합 프로세스로 바꿨습니다.
PROC_READ : process(ram, tail) begin rd_data <= ram(tail); end process;
안타깝게도 이 코드는 블록 RAM에 매핑되지 않습니다. RAM 출력과 rd_data 신호의 첫 다운스트림 레지스터 사이에 조합 로직이 생길 수 있기 때문입니다.
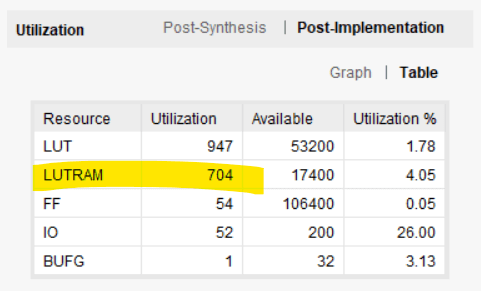
아래 이미지는 Vivado가 보고한 리소스 사용량입니다. 블록 RAM이 LUTRAM(룩업 테이블로 구현된 분산 RAM)으로 대체되었고, LUT 사용량이 37개에서 947개로 폭증했습니다. 룩업 테이블과 플립플롭은 블록 RAM보다 비싸므로 애초에 블록 RAM이 존재하는 이유입니다.
블록 RAM에서 링 버퍼 FIFO를 구현하는 방법은 많습니다. 다른 설계로 추가 클록 사이클을 아낄 수도 있지만, 추가 지원 로직 비용이 듭니다. 대부분의 애플리케이션에서는 이 글에서 제시한 링 버퍼로 충분합니다.
업데이트: AXI ready/valid 핸드셰이크를 사용한 블록 RAM 링 버퍼 FIFO 만들기
다음 블로그 글에서는 제약 랜덤 검증을 사용해 링 버퍼 모듈의 더 나은 테스트벤치를 만들 예정입니다.