오늘날 누구에게 물어봐도 인공지능(AI)은 '다음 빅뱅', 모두가 탐내지만 아무도 온전히 씹어 먹지 못한 '뜨거운 감자'라고 답할 것입니다.
대다수는 지금의 AI 열풍이 그저 '과대포장'—좋은 옛 머신러닝과 수학을 파워포인트로 포장한 것—이라 말하겠죠. 상당 부분 맞는 말입니다.
하지만 자연어 처리(NLP) 분야에서 딥러닝 등 AI 도구의 적용은 그야말로 혁명적이었습니다.
웹사이트 챗봇이 쉬운 예입니다. LSTM(Long Short-Term Memory) 신경망이 문맥을 '이해'하고 일관된 문장을 생성합니다. 소크라테스는 아니어도, 무작위 단어 나열이 아닌 '낮은 수준의 지능'은 분명해 보입니다.
단어 임베딩(Word Embeddings)
현대 NLP 딥러닝의 포문은 2013년 토마스 미콜로프(Tomas Mikolov)의 Word2Vec 논문이 열었습니다. 신경망으로 단어 임베딩(단어 벡터)을 계산 가능하게 만든 쾌거였습니다.
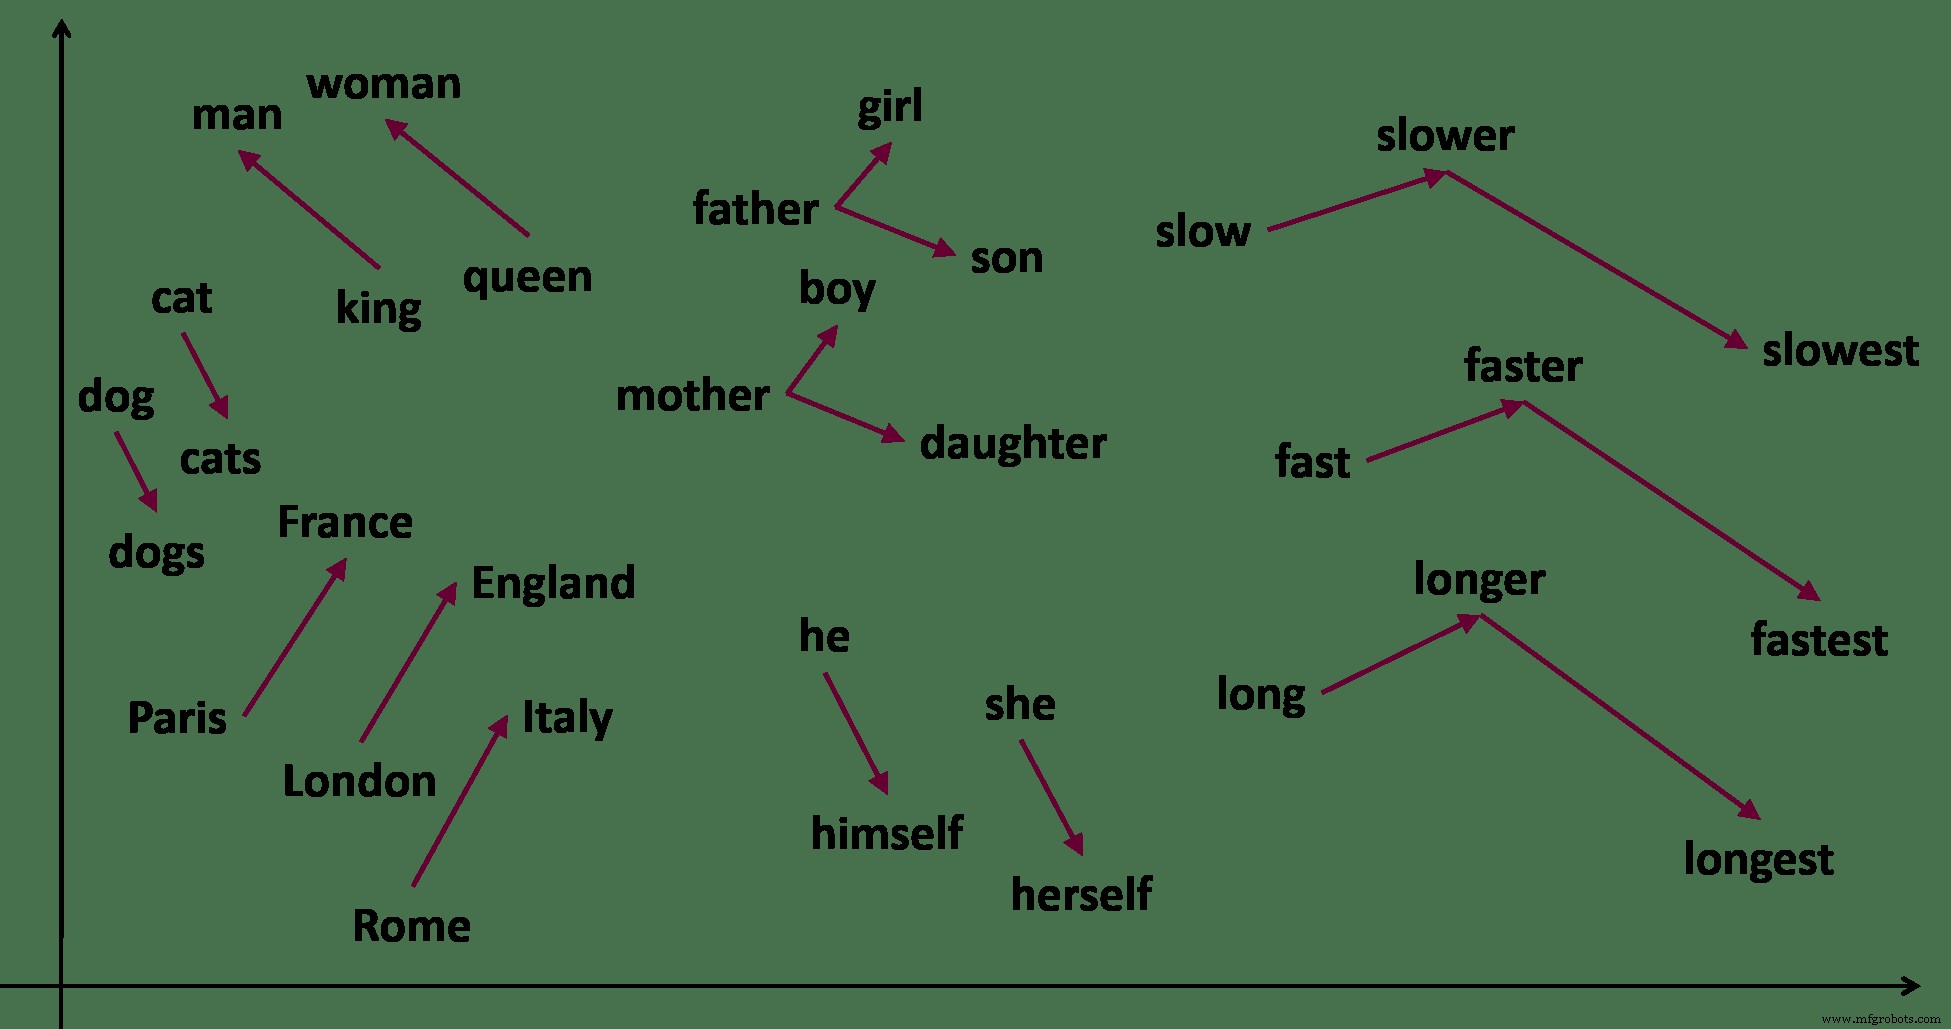
man(남자), woman(여자), king(왕), queen(여왕) 네 단어를 그룹핑해 보세요. [man, woman], [king, queen] 또는 [man, king], [woman, queen] 등으로 나눌 수 있습니다.
저는 king - man = queen - woman 관계가 성립함을 압니다. 이 단어를 처음 본 사람도 문장 속 단어 근접성만 관찰하면 이 관계를 학습할 수 있습니다. 'This man is a king', 'The queen was a godly woman'... 문맥만으로 king은 주로 man, queen은 주로 woman과 연관됨을 추론합니다.
단어 임베딩이 텍스트 내 단어 간 의미 관계 포착. 출처: samyzaf.com
단어 임베딩은 이를 수천만 단어, 수천만 문서 규모로 수행합니다. 핵심은 문맥(Context)에서 학습한다는 점. 현대 연산 능력과 딥러닝의 마법이 이 수학적 유추 게임을 가능케 했습니다.
딥러닝 단어 임베딩의 작동 원리
해리포터 전권의 단어 임베딩을 구한다고 가정해 봅시다.
우선 모든 단어를 담을 벡터 공간(Vector Space)이라는 다차원 '수학적 금고'를 만듭니다. Dress(드레스)와 Cloak(망토)는 같은 금고에, Quidditch(퀴디치)와 Snitch(스니치)는 인접 금고에, Car(자동차)와 Centaur(켄타우로스)는 Banana(바나나)와 Voldemort(볼드모트)만큼 멀리 떨어뜨립니다.
단어 임베딩 = 해당 단어가 놓인 금고의 주소(벡터)입니다. 인간이 하기엔 단어 수도, 이동량도 너무 많습니다.
하지만 심층 신경망은 이 일을 탁월히 해냅니다. 수백만 기어와 레버로 된 거대 기계가 처음엔 혼돈뿐이지만, 점차 톱니가 맞물리고 질서가 생겨납니다. 프랑켄슈타인이 깨어나는 순간입니다.
근본적으로 신경망이 '어떻게' 하는지 우리는 아직 모릅니다. 레이어 수, 활성화 함수, 뉴런 수 등을 튜닝하며 실험하는 이유입니다. 이는 별도 주제로 미룹니다.
열전 소재(Thermoelectrics) 발굴에 적용하다
2019년 로렌스 버클리 연구진은 약 1,000개 저널, 330만 편 논문 초록의 단어 임베딩을 생성했습니다. 최근 20여 년 소재과학 거의 전 분야를 아우르는 방대한 데이터입니다.
과학 텍스트에선 화학식과 기호도 '단어'입니다. LiCoO₂(대표적 리튬이온 배터리 양극재)도 벡터로 존재합니다. 그렇다면 "LiCoO₂와 가장 가까운 벡터는 무엇인가?"를 물어볼 수 있습니다.
벡터 공간에서 LiCoO₂ 인근 벡터를 탐색하면 답이 나옵니다: LiMn₂O₄, LiNi₀.₅Mn₁.₅O₄, LiNi₀.₈Co₀.₂O₂, LiNi₀.₈Co₀.₁₅Al₀.₀₅O₂, LiNiO₂ — 모두 리튬이온 배터리 양극 소재들입니다.
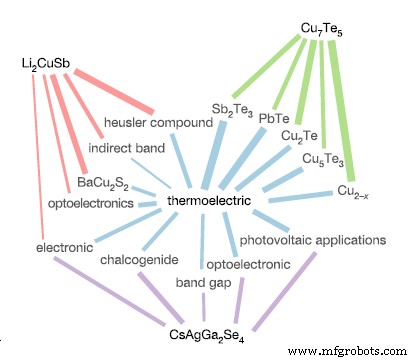
화학 화합물과 'thermoelectric' 벡터 간 관계 경로. Li₂CuSb는 직접 연관 없으나 'indirect band', 'optoelectronics' 등 지표어 인근에 위치. [2]
우리가 한 일의 의미
수천 편 논문을 읽고 리튬 화합물 리스트를 수작업으로 정리하던 일을, 단어 임베딩이 수초 만에 해결했습니다. 의미론적 탐색을 벡터 연산으로 치환해 거대 텍스트 DB를 효율적으로 질의·이해하는 힘입니다.
더 나아가 연구진은 화학 화합물이 'thermoelectric(열전)' 벡터 근처에 얼마나 자주 출현하는지 분석했습니다. 내적(Dot Product) 연산으로 유사도 측정(유사→1, 비유사→0). 이를 통해 '열전 소재일 가능성이 높은 화학 물질'을 전수 추출했습니다.
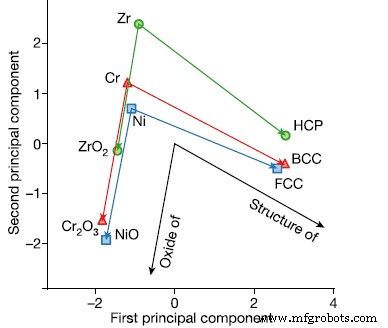
초록 DB 단어 임베딩으로 'Zr이 Hexagonal이면 Chromium은?' → 'Body Centered' 등 결정구조·강유전성 관계도 포착. [2]
이 기법으로 기존 열전 소재 다수가 과거 문헌에서 이미 예측 가능했음이 입증되었습니다. 이 분석은 "인류가 연구한 모든 소재 중, 열전 소재일 가능성이 높은 것은 무엇인가?"라는 질문에 대한 우아하면서도 기만적으로 간결한 수학적 답변입니다.
소재 데이터베이스, 지금 당장 필요한 이유
이미 그런 리스트가 있지 않냐고요? 누군가 지난 연구를 다 정리해 뒀을 것 같지만, 놀랍게도 그렇지 않습니다. 방대한 지식이 책·저널·논문 속에 잠겨 있고, 수작업 스캔은 불가능합니다.
이것이 단어 임베딩과 이 논문의 기법이 혁명적인 이유입니다. 텍스트와의 상호작용 방식을 바꾸고, 소재 데이터베이스 구축을 비약적으로 가속화할 것입니다.
어떤 소재들이 압전성 연구 대상이었나? 문헌 속에서 놓친 초전도체는 없나? 알츠하이머 치료 신약 후보는? 단어 임베딩에게 물어보세요. 그들이 알고 있습니다.